
84 lines
4.6 KiB
Markdown
84 lines
4.6 KiB
Markdown
# Lektionens trin
|
|
|
|
🌐 [English](Lecture-Steps) · **Dansk** · [Bahasa Malaysia](Lecture-Steps-ms)
|
|
|
|
Lektionen bygger `interaction.py` i syv trin. Hvert trin nedenfor har sit skærmbillede, koden som den ser ud efter trinnet og det, vi lærte.
|
|
|
|
## Trin 1: Opret `interaction.py`
|
|
|
|
|
|
|
|
```python
|
|
# interaction.py
|
|
```
|
|
|
|
**Det lærte vi:** et sted til scriptet. Én lille fil med ét formål er lettere at læse og sammenligne med andres løsninger end kode spredt over mange filer.
|
|
|
|
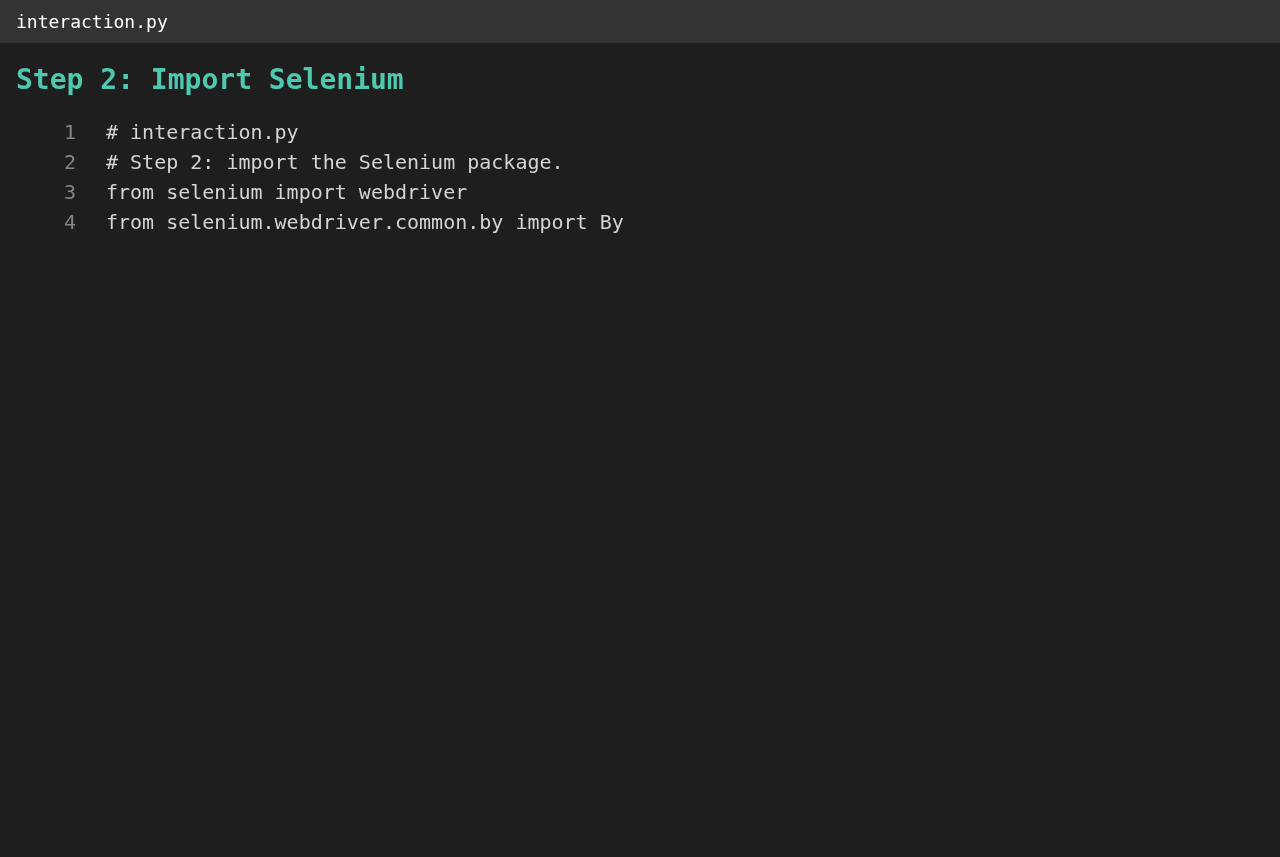
## Trin 2: Importér Selenium
|
|
|
|
|
|
|
|
```python
|
|
from selenium import webdriver
|
|
from selenium.webdriver.common.by import By
|
|
```
|
|
|
|
**Det lærte vi:** Selenium er en pakke, der styrer en rigtig browser fra Python. `webdriver` starter og styrer browseren; `By` angiver, hvordan et element findes (med CSS-selector, id, navn og så videre). Det er en tredjepartspakke, så den skal først installeres i `.venv`.
|
|
|
|
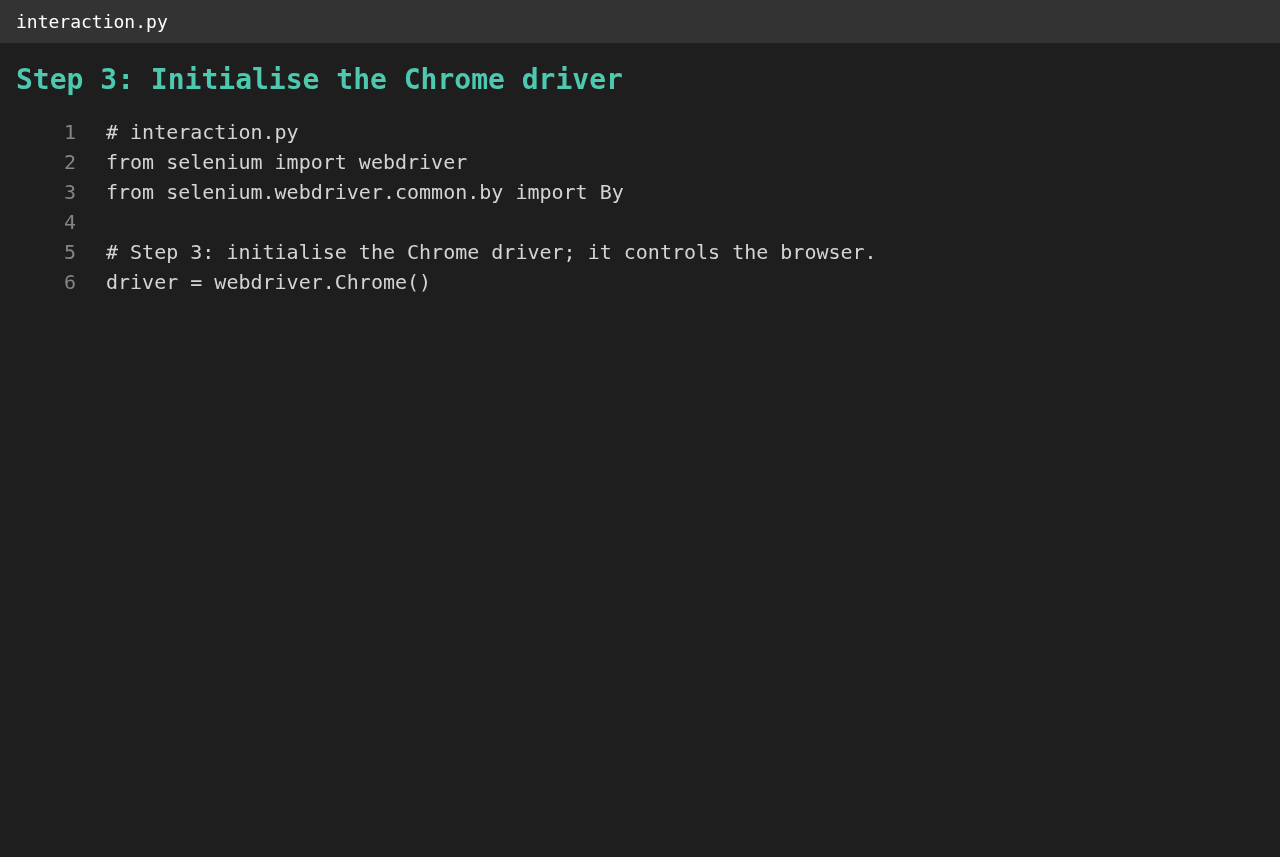
## Trin 3: Initialisér Chrome-driveren
|
|
|
|
|
|
|
|
```python
|
|
driver = webdriver.Chrome()
|
|
```
|
|
|
|
**Det lærte vi:** driveren er det objekt, som scriptet bruger til at styre Chrome: åbne sider, finde elementer og lukke browseren. Når den oprettes, åbner et rigtigt browservindue. I vores projekt er det `create_driver()`, som også kan starte Chrome uden vindue (`--headless`) til Docker.
|
|
|
|
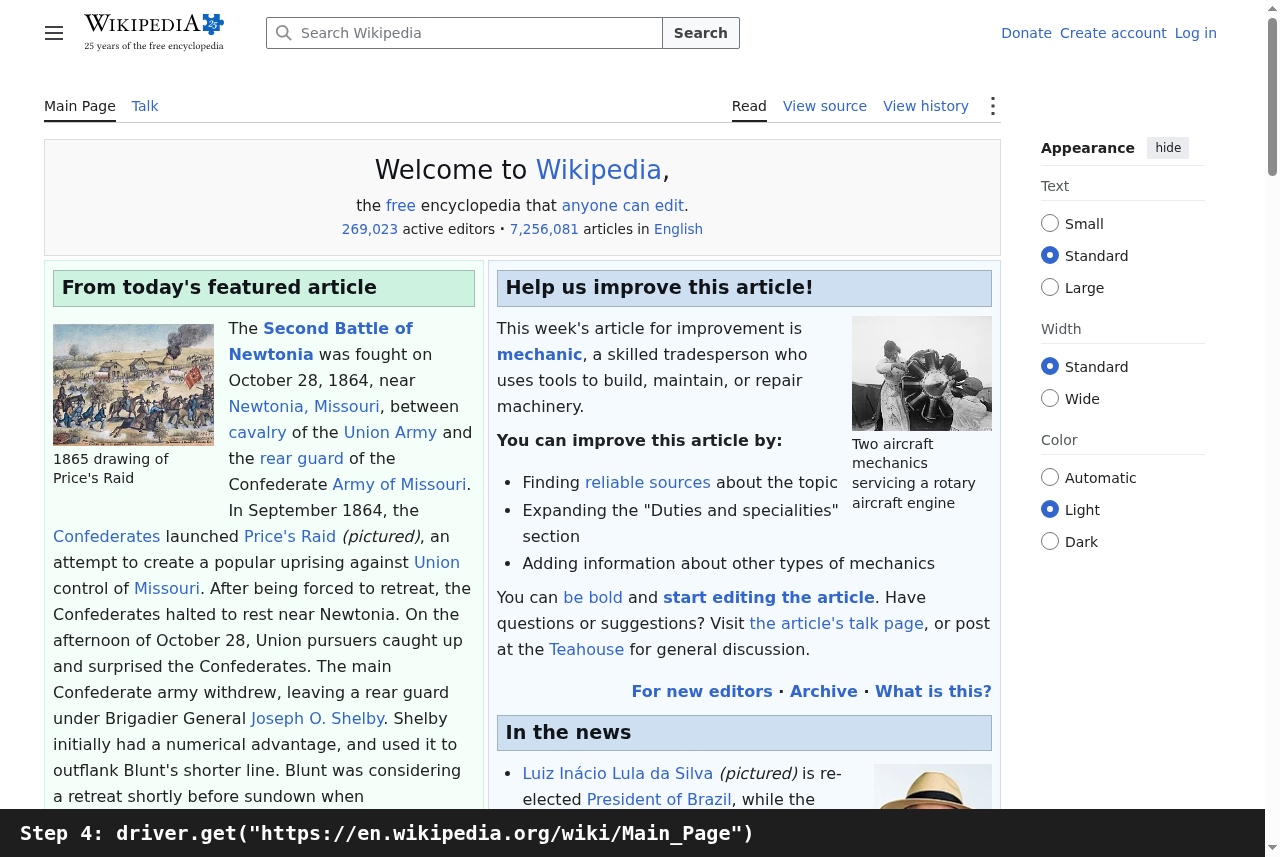
## Trin 4: Gå til Wikipedia med `get()`
|
|
|
|
|
|
|
|
```python
|
|
driver.get("https://en.wikipedia.org/wiki/Main_Page")
|
|
```
|
|
|
|
**Det lærte vi:** `get()` henter en URL og venter, til siden er indlæst. URL'en er en konstant (`WIKIPEDIA_MAIN_PAGE_URL` i `constants.py`), så den står ét sted. I vores projekt er det `open_main_page()`.
|
|
|
|
## Trin 5: Find HTML-elementet
|
|
|
|
|
|
|
|
```python
|
|
# The article count is the anchor (a) inside the div whose id is "articlecount":
|
|
# #articlecount a
|
|
```
|
|
|
|
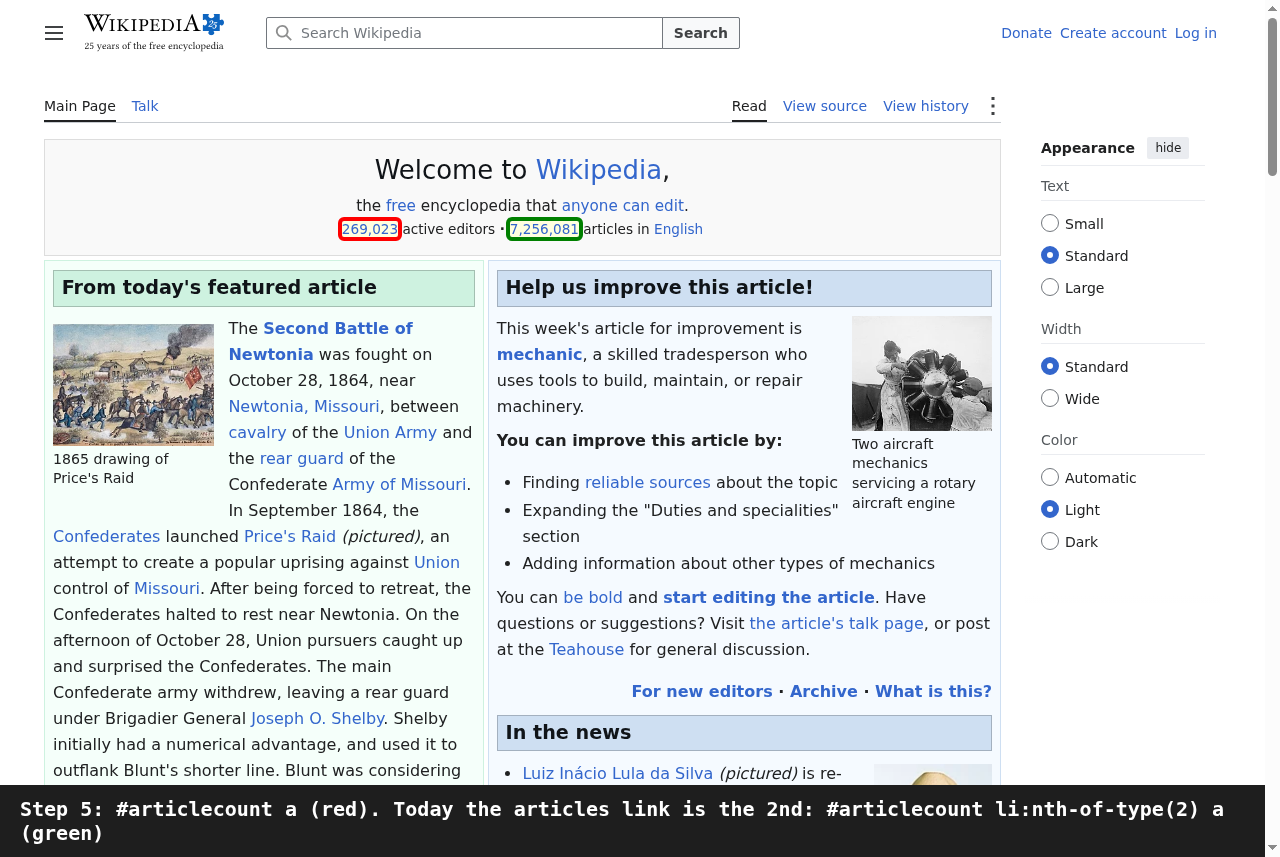
**Det lærte vi:** før man scraper, kigger man på sidens HTML (browserens udviklerværktøjer viser den) og finder et element, der sikkert kan skelnes fra resten. Et `id` er unikt på en side, så `#articlecount` er et godt ankerpunkt for en CSS-selector, og `a` vælger linket indeni.
|
|
|
|
**En lektion fra 2026:** Wikipedia har siden tilføjet et andet link i den `div`. Det første match (rødt på skærmbilledet) er nu antallet af aktive redaktører, og artikeltallet (grønt) er det første link i det andet listepunkt: `#articlecount li:nth-of-type(2) a`. Programmet bruger den selector (`ARTICLE_COUNT_SELECTOR`) og beholder lektionens selector som `LECTURE_SELECTOR`. Sider ændrer sig; en selector skal kontrolleres mod siden, og end to end-testen kontrollerer, at det udskrevne tal er mindst en million.
|
|
|
|
## Trin 6: Find elementet og udskriv dets tekst
|
|
|
|
|
|
|
|
```python
|
|
article_count = driver.find_element(By.CSS_SELECTOR, "#articlecount a")
|
|
print(article_count.text)
|
|
|
|
driver.quit()
|
|
```
|
|
|
|
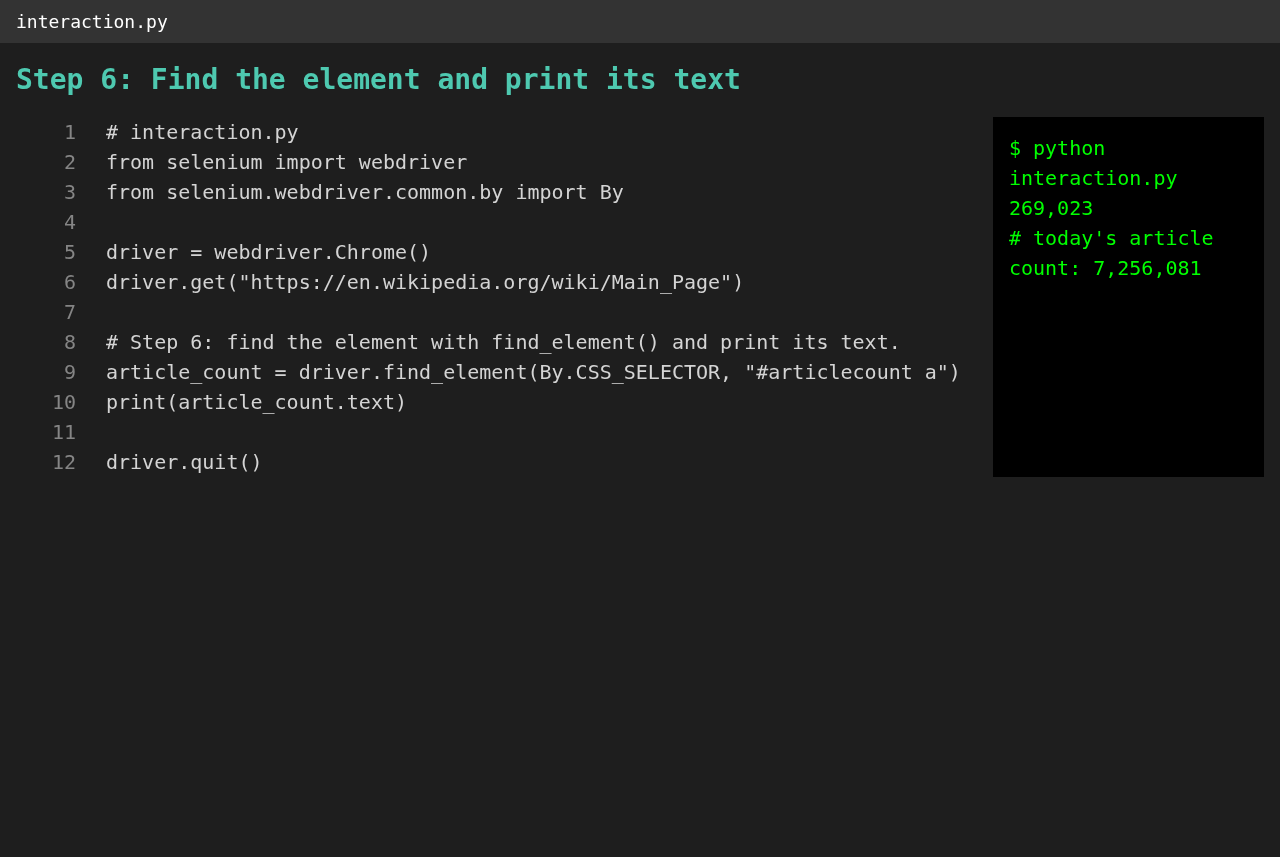
**Det lærte vi:** `find_element` returnerer det første element, der passer, og `.text` giver den tekst, en besøgende ser. `driver.quit()` lukker browseren; vores `main()` gør det i en `finally`-blok, så browseren lukkes, selv hvis noget fejler. Terminalpanelet på skærmbilledet viser, hvad lektionens selector returnerer i dag, og under det det rigtige artikeltal.
|
|
|
|
## Trin 7: Hvad kommer næste gang
|
|
|
|
|
|
|
|
```python
|
|
# article_count.click() # click a link
|
|
# search = driver.find_element(By.NAME, "search") # type into a search field
|
|
```
|
|
|
|
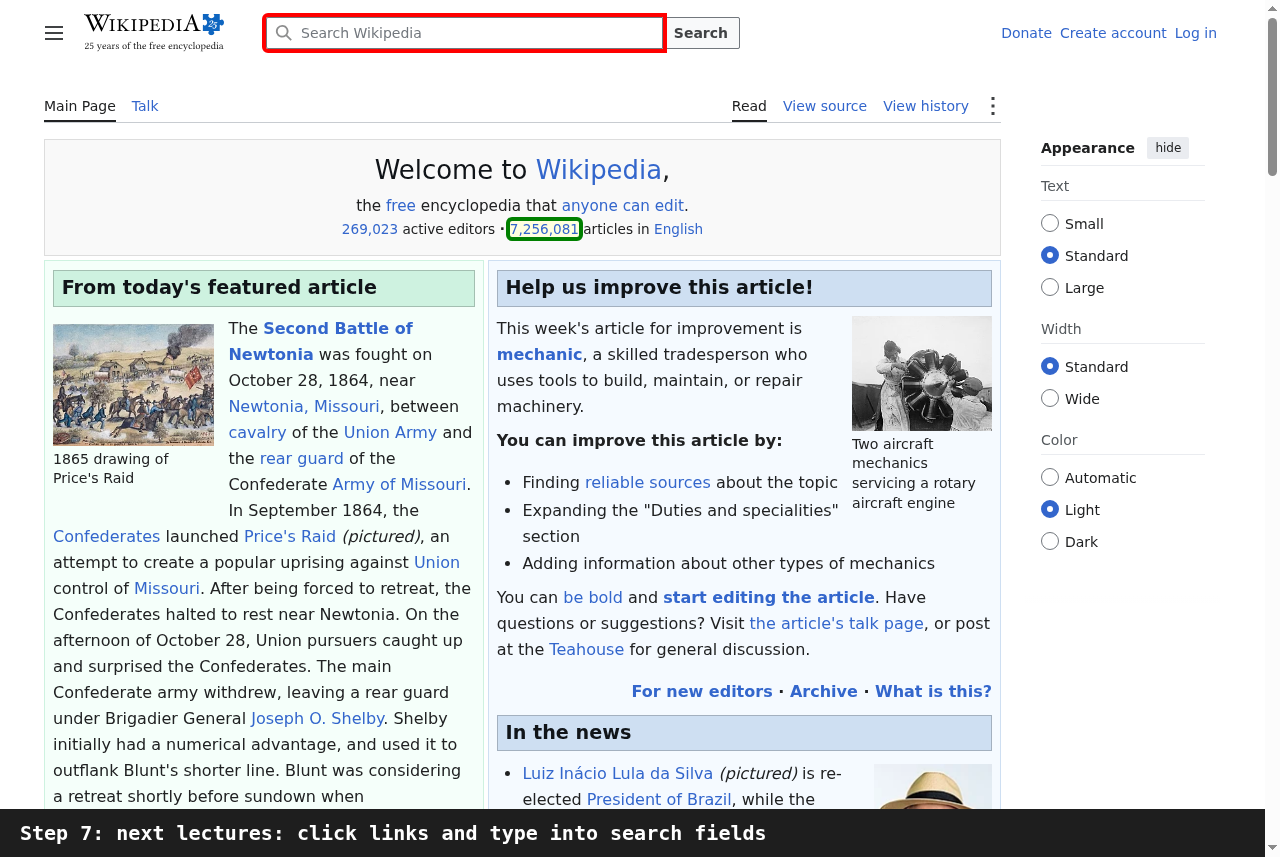
**Det lærte vi:** at læse er kun halvdelen. De næste lektioner klikker på links og skriver i felter som søgefeltet (markeret på skærmbilledet). De samme to ideer gælder: find elementet med en selector, og handl så på det.
|