1
Step 1 Scrape the Billboard da
Tirsvad edited this page 2026-10-28 07:41:17 +01:00
Trin 1 - Scrape Billboard Hot 100
🌐 English · Dansk · Bahasa Melayu
Hvad trinnet gør
Programmet beder om en dato i formatet YYYY-MM-DD, henter https://appbrewery.github.io/bakeboard-hot-100/<date>/ og læser de 100 sange ud af HTML'en. Bakeboard er kursets kopi af Billboard Hot 100, fordi den rigtige side kan ændre sig eller få en betalingsmur når som helst.
python -m musical_time_machine --list-only
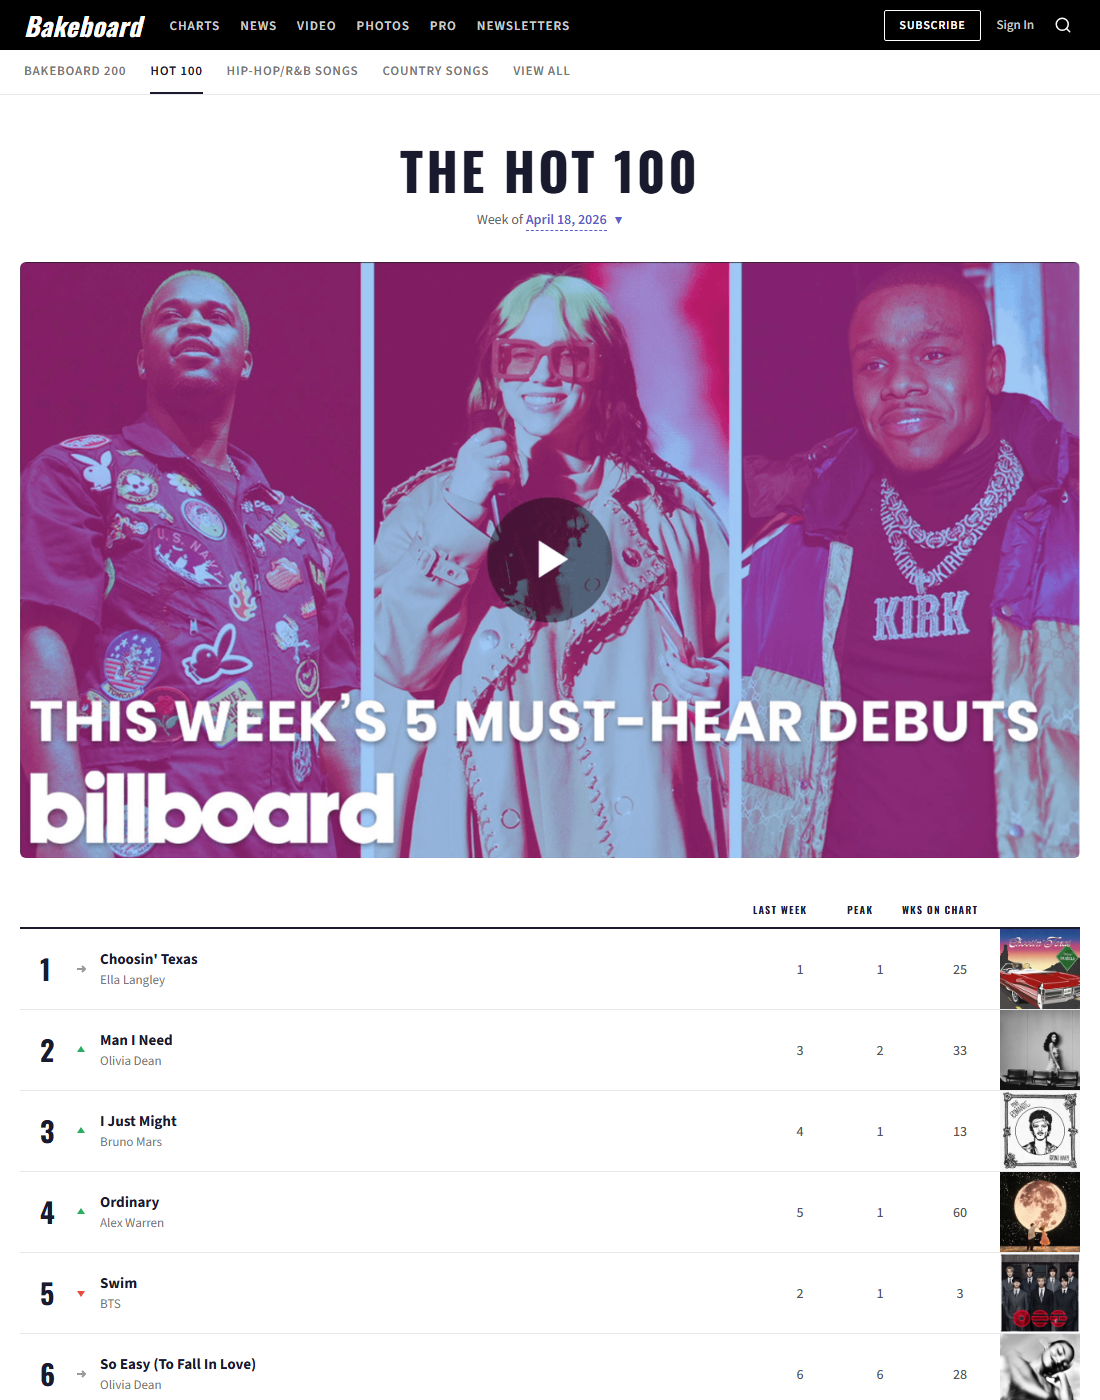
Bakeboard-siden for 2026-04-18:
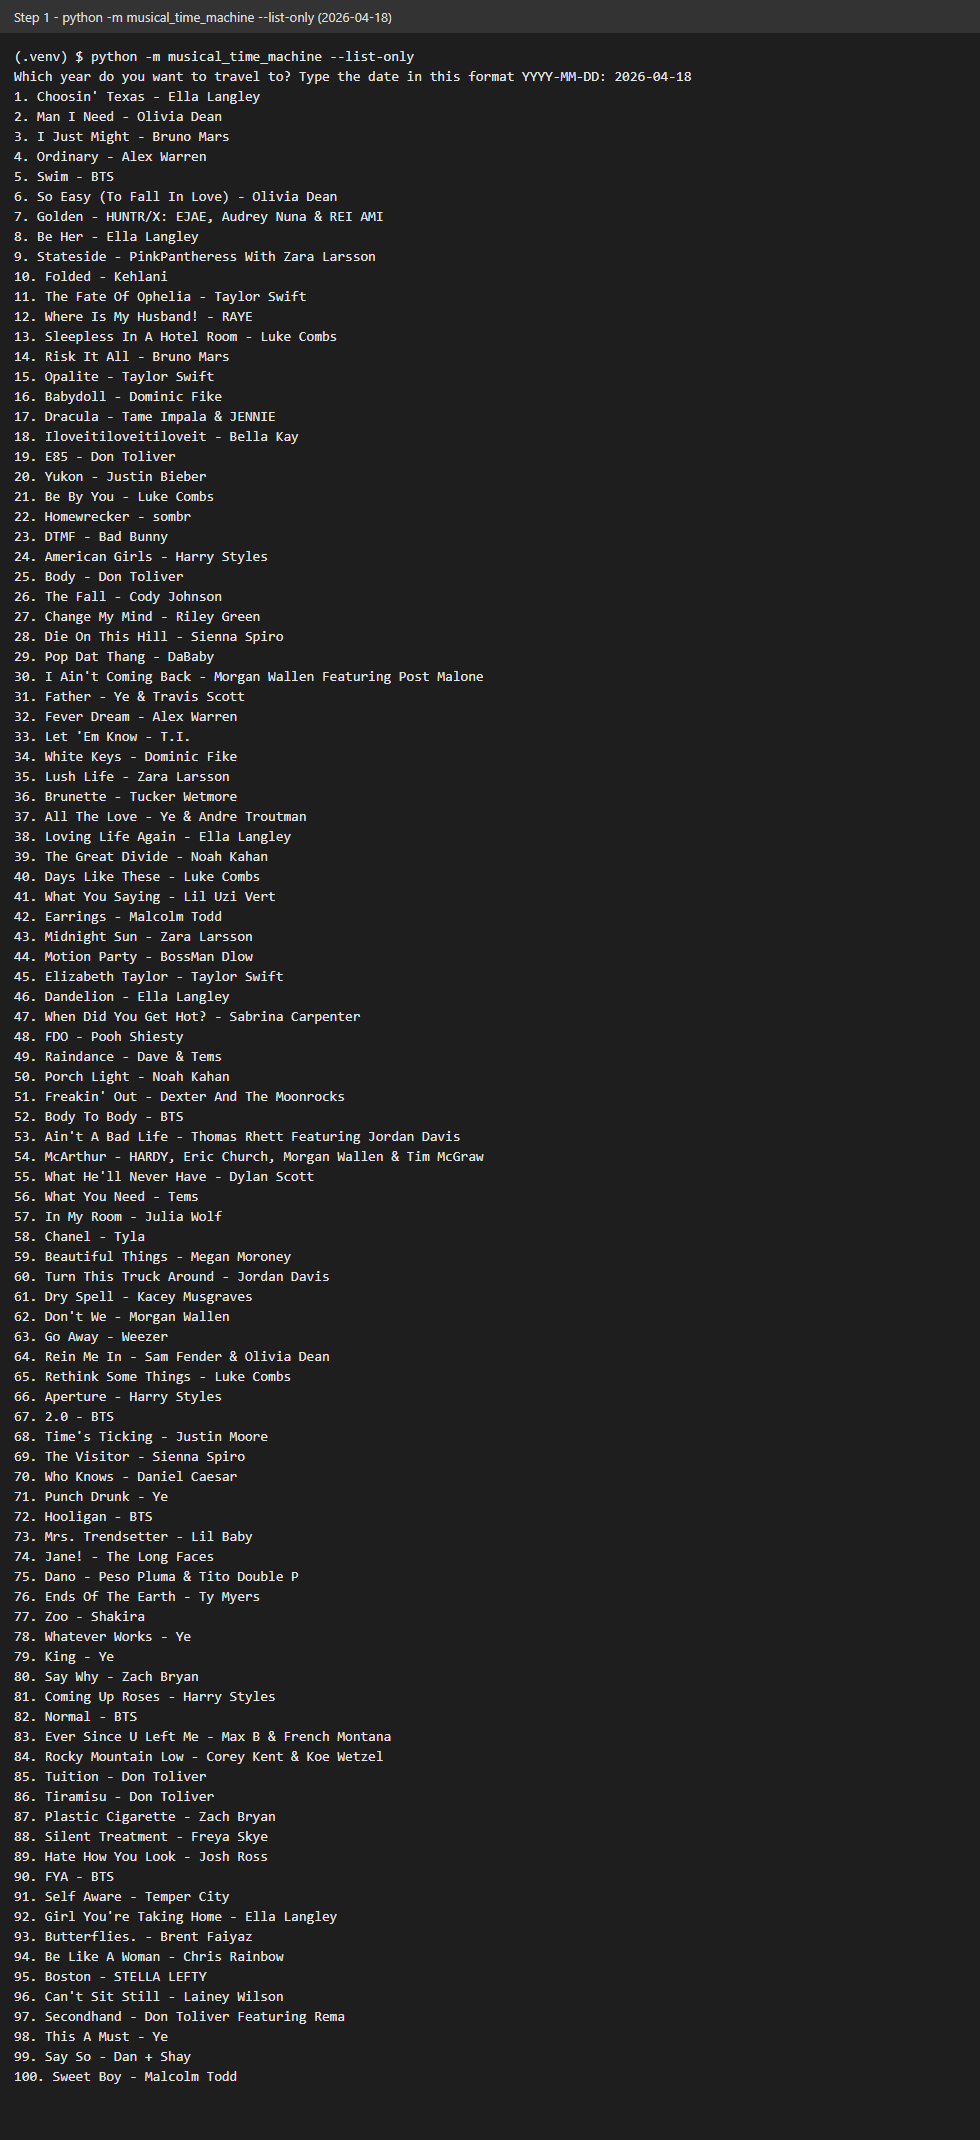
Programmets output (gengivet ud fra teksten fra en rigtig kørsel, ikke et foto af et terminalvindue):
Det lærte vi
- At læse en hjemmeside som data.
BeautifulSoupgør HTML til et træ, og en CSS-selektor (div.chart-entry,h3.chart-entry__title) udpeger de dele, vi vil have. Vi fandt selektorerne ved først at se på sidens markup. - At være en høflig klient. En anmodning har hoveder (headers);
User-Agentfortæller serveren, hvilken slags klient der spørger. Entimeoutograise_for_status()får en langsom eller manglende side til at fejle tydeligt i stedet for at hænge. - At validere input ved grænsen.
parse_chart_dateaccepterer kun rigtigeYYYY-MM-DD-datoer, så resten af programmet aldrig ser en ugyldig dato. - At teste uden netværk. Hitlistesiden er gemt under
tests/fixtures/, og scraperen tager sin sidehenter som parameter, så testene kontrollerer 100 sange uden en eneste anmodning. - At samle viden ét sted. URL, selektorer og beskeder ligger i
constants.py; hvis Bakeboard ændrer sit markup, er det én fil, der ændres.