English · Dansk · Bahasa Melayu
Top 100 film
Forelæsning: Projektet med de 100 film. Målet er movies.txt med titlerne nummereret fra 1) og opefter. Koden er empire_movies.py (parsing), movie.py (vend om og nummerér) og movie_file.py (skrivning).
Trin 1: vælg siden
Opgaven fastlåser et øjebliksbillede fra Internet Archive af Empires liste, fordi levende websteder ændrer sig. Skærmbilledet viser sidens gemte overskrifter.
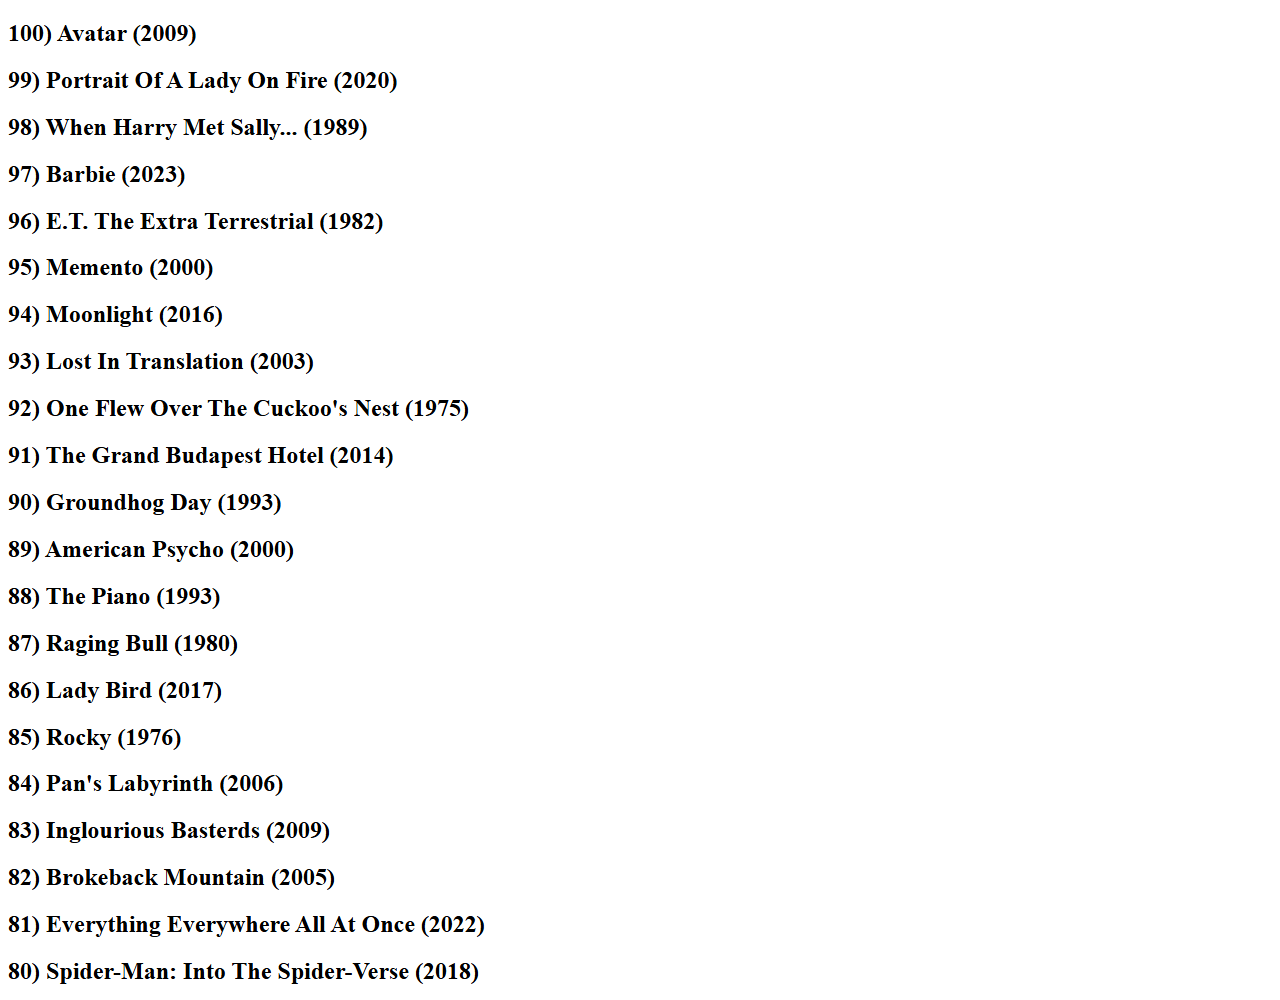
Hvad vi lærte: et fastlåst øjebliksbillede gør en scraper gentagelig.
Trin 2: undersøg markup
Siden fra 2020 har <h3 class="title">; den nuværende side har <h2><strong>-overskrifter, der begynder med en placering.
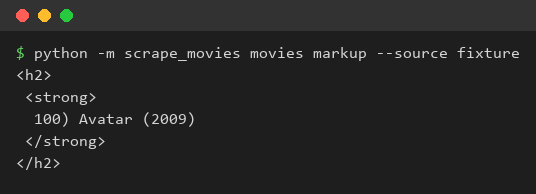
Hvad vi lærte: når et websted ændrer markup, skal parseren følge med, så vi dækker begge opbygninger.
Trin 3: titler i sidens rækkefølge
select("h3.title") og en list comprehension over get_text(). Siden tæller ned fra 100.
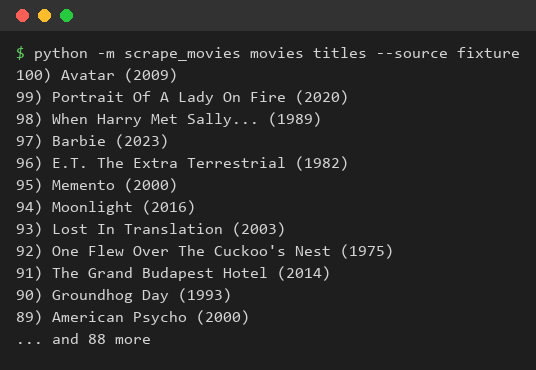
Hvad vi lærte: en list comprehension er den kompakte måde at samle tekst fra mange tags.
Trin 4: vend listen om
titles[::-1] får listen til at tælle op fra 1.
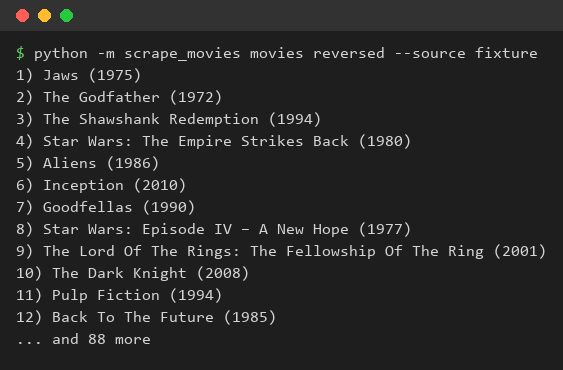
Hvad vi lærte: udsnit med negativt trin vender en liste om i ét udtryk.
Trin 5: skriv movies.txt
En with open(...)-blok skriver én titel pr. linje.
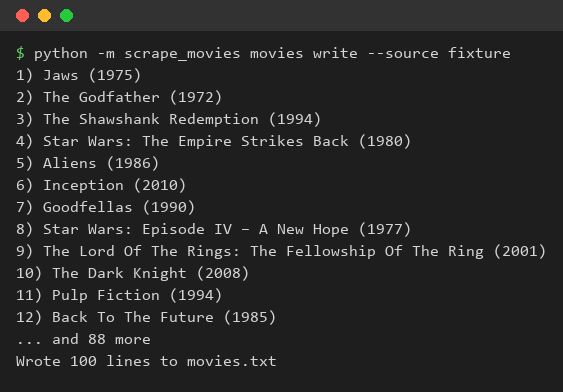
Hvad vi lærte: kontekstmanageren lukker filen for os, og den samme kørsel giver altid den samme fil.
Trin 6: resultatet
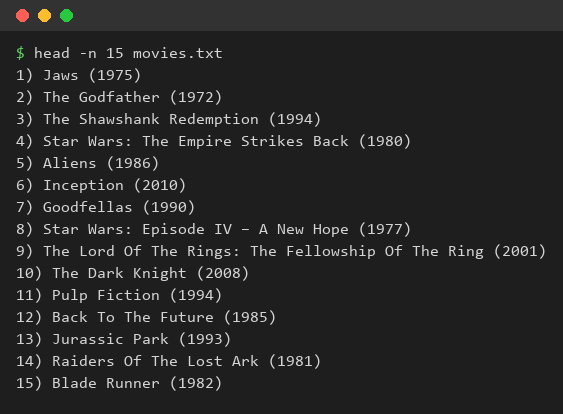
Hvad vi lærte: en personlig film-seerliste fra et websted, klar til at vælge en film tilfældigt.
Note om data
movies.txt blev lavet ud fra Empires nuværende liste den 2026-10-28, så placeringerne afviger fra listen fra 2020 i forelæsningen. Internet Archive svarede 429 Too Many Requests, mens vi byggede projektet, så opbygningen af øjebliksbilledet er dækket af et håndskrevet eksempel i testene.
Hvad vi lærte
Vi kan scrape en rangeret liste, lægge den i den rækkefølge vi vil have og gemme den i en fil.