English · Dansk · Bahasa Melayu
Menghurai HTML
Kuliah: Menghurai HTML dan Membuat Sup dan Mencari dan Memilih Elemen. Halaman contoh ialah tests/fixtures/website.html; kodnya ialah soup_basics.py.
Langkah 1: cipta sup dan baca tajuk
BeautifulSoup(html, "html.parser") menukar teks HTML menjadi objek sup. soup.title.string ialah teks dalam tag title.
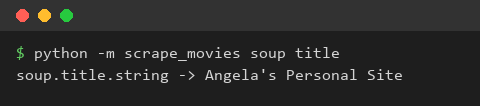
Apa yang kita pelajari: teks HTML menjadi objek yang boleh dilayari, dan satu tag dicapai dengan akses atribut biasa.
Langkah 2: prettify
soup.prettify() menulis dokumen dengan satu tag setiap baris supaya sarangan kelihatan.
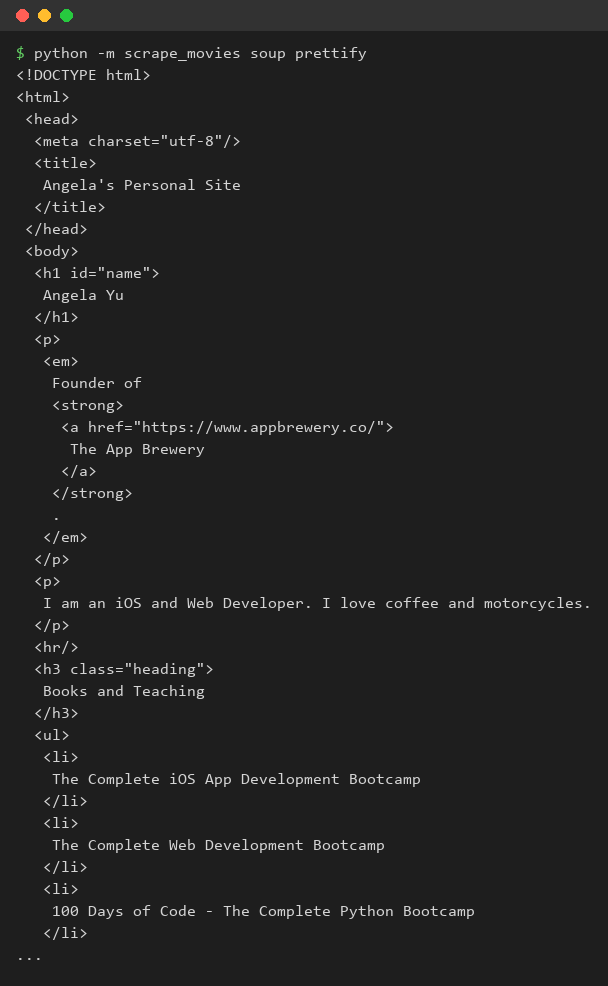
Apa yang kita pelajari: dengan membaca struktur dahulu, kita tahu apa yang perlu diminta.
Langkah 3: cari semua tag
find_all("a") memberi semua pautan. Dalam gelung, get_text() memberi teks dan get("href") memberi alamat.
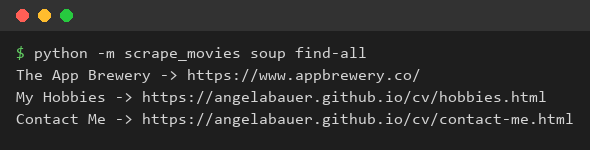
Apa yang kita pelajari: satu panggilan menemui banyak elemen, dan gelung menukarnya menjadi data.
Langkah 4: cari mengikut id dan kelas
find(id="name") mencari satu tag mengikut id. find_all("h3", class_="heading") menapis mengikut tag dan kelas; kata kuncinya ialah class_ kerana class ialah kata kunci Python.
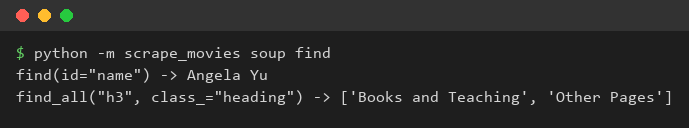
Apa yang kita pelajari: atribut mengecilkan carian, dan kita mengelak pertembungan dengan kata terpelihara.
Langkah 5: pemilih CSS
select_one("p a") dan select(".heading") menggunakan pemilih yang sama seperti CSS, jadi elemen bersarang dicapai dalam satu ungkapan.
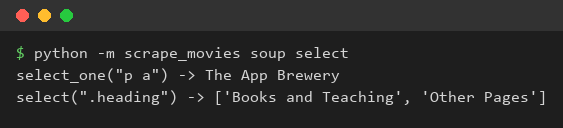
Apa yang kita pelajari: pemilih CSS ialah cara paling ringkas untuk menerangkan kedudukan elemen dalam dokumen.
Apa yang kita pelajari
Kita boleh membaca fail HTML ke dalam BeautifulSoup, melihat strukturnya dan memilih satu atau banyak elemen mengikut tag, id, kelas atau pemilih CSS.