
1.3 KiB
1.3 KiB
English · Dansk · Bahasa Melayu
Er web scraping lovligt og etisk?
Forelæsning: Web scrapings juridiske og etiske side. Dette er et resumé med egne ord og ikke juridisk rådgivning.
Trin 1: læs robots.txt først
Et websteds robots.txt fortæller, hvad det tillader. Hacker News forbyder nogle stier og beder om en pause på 30 sekunder mellem forespørgsler.
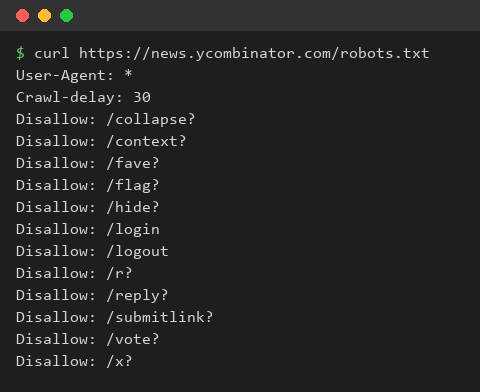
Hvad vi lærte: vi tjekker reglerne, før vi scraper, og vi holder forespørgslerne sjældne: dette projekt henter én side pr. kørsel.
Reglerne vi følger
- Offentlige data uden ophavsret må generelt gerne læses. Sagerne Genius mod Google og hiQ mod LinkedIn viser, at grænsen ikke er enkel.
- Indhold med ophavsret, som videoer eller blogindlæg, må ikke kopieres. Data bag et login er omfattet af webstedets brugeraftale.
- Kommerciel brug af scrapede data kan føre til dyre tvister, selv når selve scrapingen var tilladt.
- Foretræk et officielt API, respektér
robots.txt, send enUser-Agent, og send højst én forespørgsel i minuttet.
Hvad vi lærte
Scraping er en teknisk færdighed med juridiske og etiske grænser. At kende grænserne er en del af at gøre det godt.