
2.4 KiB
English · Dansk · Bahasa Melayu
Parsing af HTML
Forelæsninger: Parsing af HTML og at lave suppe og Find og vælg elementer. Eksempelsiden er tests/fixtures/website.html; koden er soup_basics.py.
Trin 1: lav en suppe og læs titlen
BeautifulSoup(html, "html.parser") gør HTML-teksten til et suppe-objekt. soup.title.string er teksten i title-tagget.
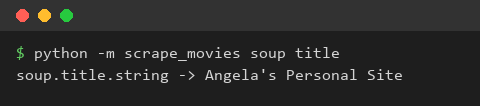
Hvad vi lærte: HTML-tekst bliver til et objekt, vi kan navigere i, og et tag nås med almindelig attributadgang.
Trin 2: prettify
soup.prettify() skriver dokumentet med ét tag pr. linje, så indlejringen bliver synlig.
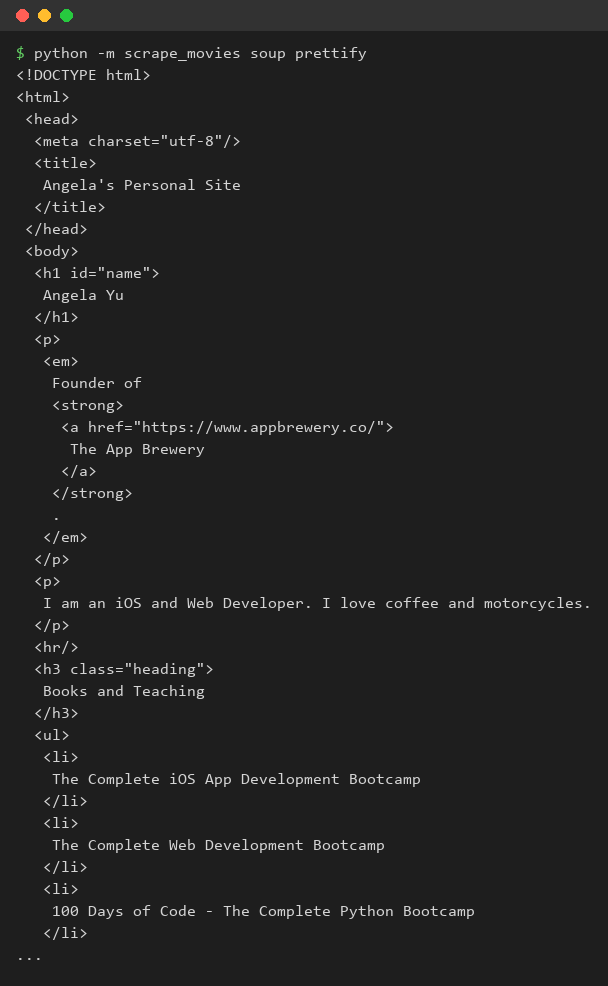
Hvad vi lærte: når vi først læser strukturen, ved vi, hvad vi skal spørge om.
Trin 3: find alle tags
find_all("a") giver alle links. I en løkke giver get_text() teksten og get("href") adressen.
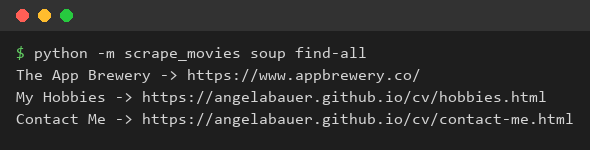
Hvad vi lærte: ét kald finder mange elementer, og en løkke gør dem til data.
Trin 4: find med id og klasse
find(id="name") finder ét tag via dets id. find_all("h3", class_="heading") filtrerer på tag og klasse; nøgleordet er class_, fordi class er et reserveret ord i Python.
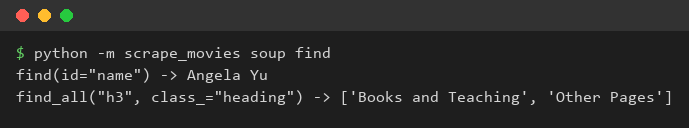
Hvad vi lærte: attributter indsnævrer en søgning, og vi undgår sammenstød med reserverede ord.
Trin 5: CSS-selektorer
select_one("p a") og select(".heading") bruger de samme selektorer som CSS, så indlejrede elementer nås i ét udtryk.
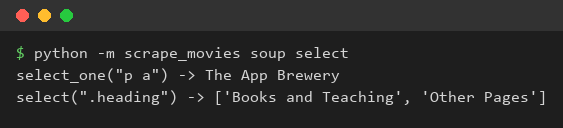
Hvad vi lærte: CSS-selektorer er den korteste måde at beskrive, hvor et element sidder i dokumentet.
Hvad vi lærte
Vi kan læse en HTML-fil ind i BeautifulSoup, se dens struktur og udvælge enkelte eller mange elementer via tag, id, klasse eller CSS-selektor.