
2.4 KiB
English · Dansk · Bahasa Melayu
Scraping af Hacker News
Forelæsning: Scraping af et live-websted. Koden er hacker_news.py (parsing) og http_client.py (ét requests.get med timeout og User-Agent). Kommandoerne læser kursets statiske kopi af siden; --source live læser det rigtige websted, og --source fixture læser den gemte kopi uden netværk.
Trin 1: se på siden
Siden viser historier med en titel, et link og en score.
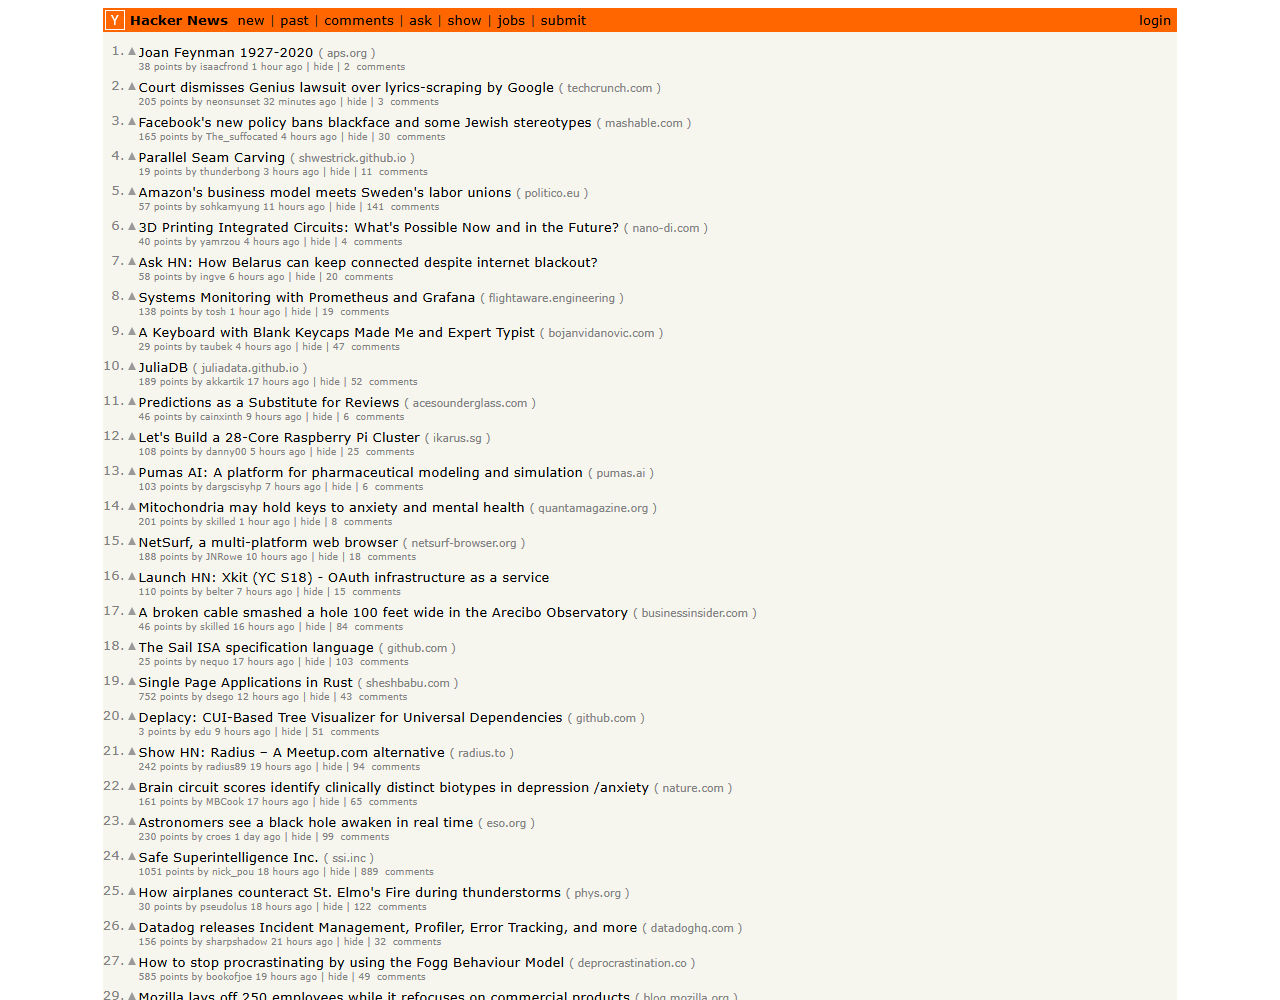
Hvad vi lærte: live-data er rigere end en lokal fil, men de kan ændre sig, så vi gemmer også en kopi til testene.
Trin 2: undersøg markup
Browserens udviklerværktøjer viser tagsene: en række tr.athing, titellinket .titleline > a og en span.score i næste række.
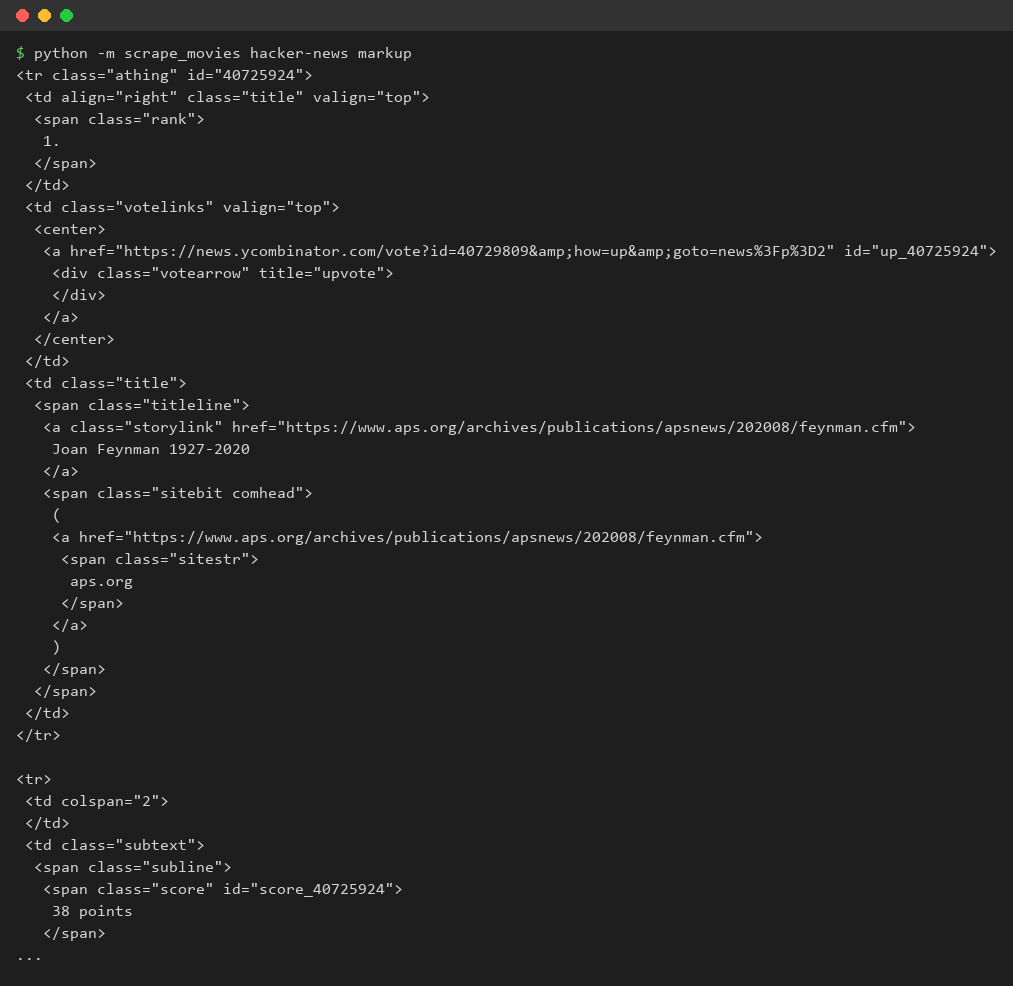
Hvad vi lærte: vi finder det rigtige tag ved at undersøge siden, før vi skriver kode.
Trin 3: titler
find_all på titellinkene og get_text().
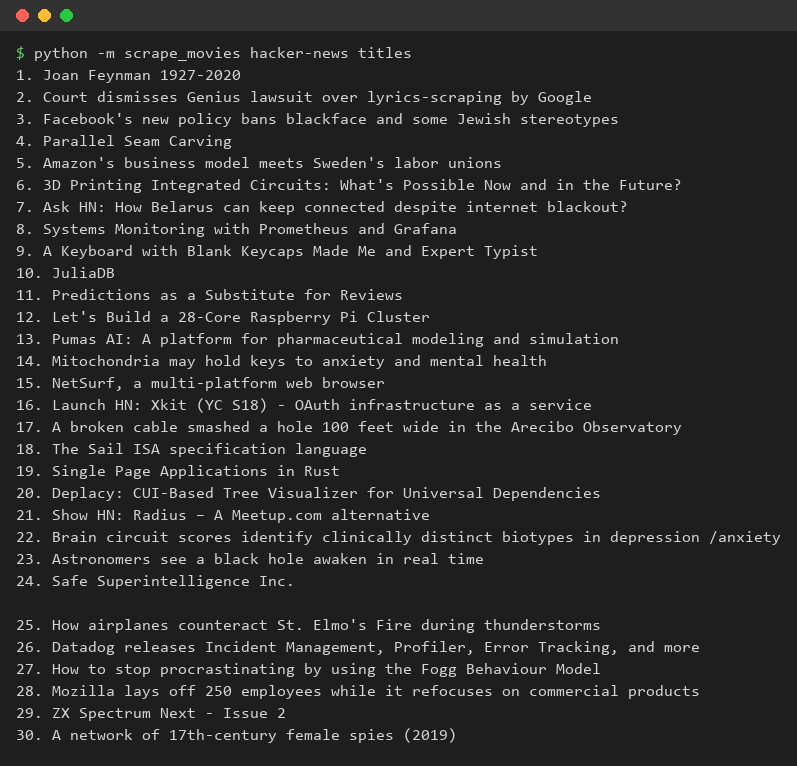
Hvad vi lærte: en list comprehension gør mange tags til en almindelig liste af strenge.
Trin 4: links
get("href") på de samme links.
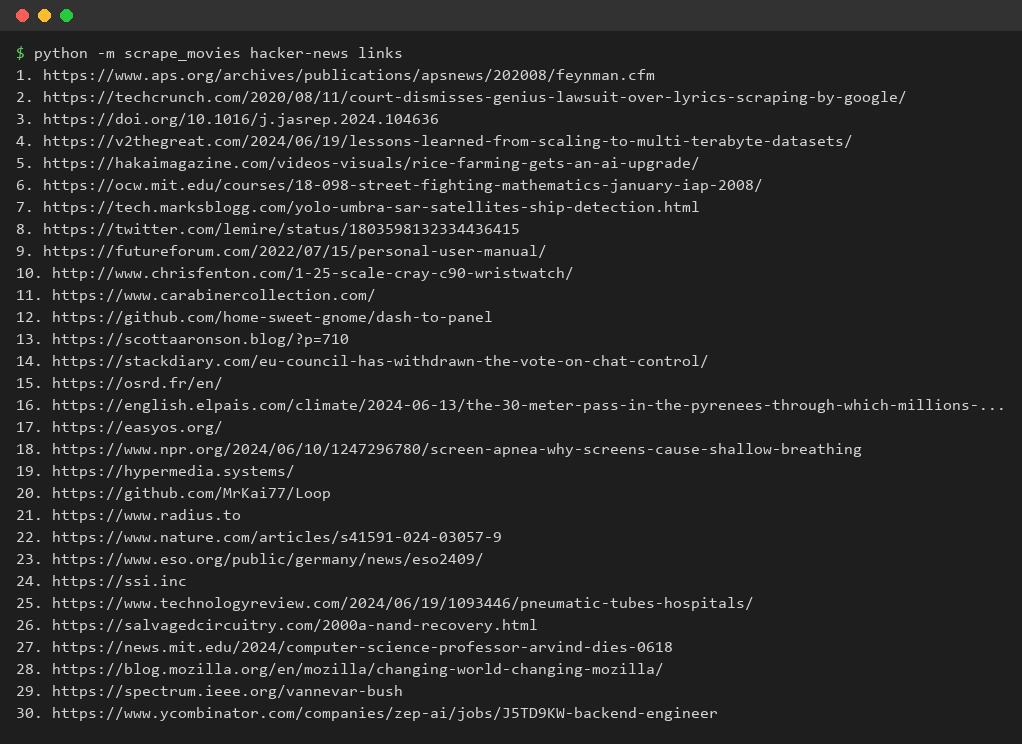
Hvad vi lærte: det samme element giver både tekst og attributværdier.
Trin 5: upvotes
Teksten 38 points deles op og omdannes med int().
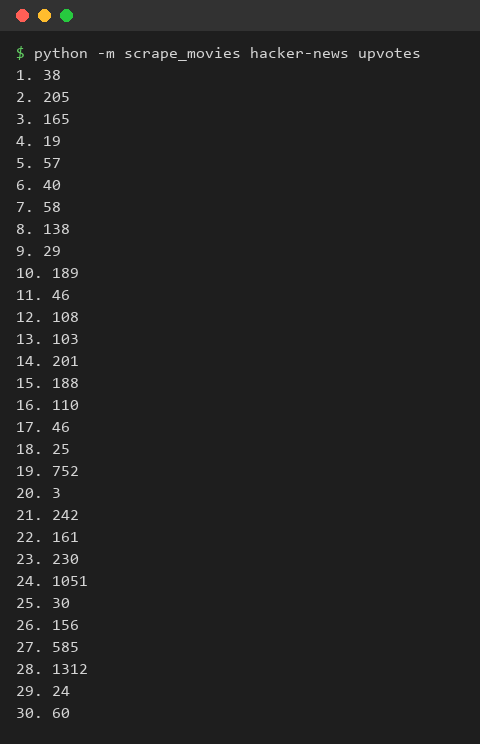
Hvad vi lærte: scrapet tekst skal omdannes til tal, før den kan sammenlignes.
Trin 6: den øverste historie
max over upvotes finder den mest populære artikel.
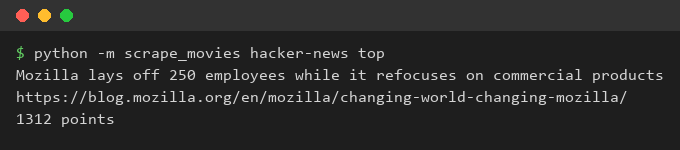
Hvad vi lærte: når data er rene, besvarer almindelig Python spørgsmål om dem.
Hvad vi lærte
Vi kan hente en side med Requests, finde rækkerne, læse titler, links og scores, omdanne dem til brugbare typer og besvare et spørgsmål om data.