MIL-005: wiki in English, Danish and Bahasa Malaysia #39
@@ -0,0 +1,17 @@
|
|||||||
|
[English](Gains) · **Dansk** · [Bahasa Melayu](Gains-ms)
|
||||||
|
|
||||||
|
# Hvad vi lærte
|
||||||
|
|
||||||
|
| Forelæsning | Hvad vi kan nu |
|
||||||
|
| --- | --- |
|
||||||
|
| [Parsing af HTML](Parsing-HTML-da) | Lave en suppe, læse dens struktur og vælge elementer via tag, id, klasse eller CSS-selektor |
|
||||||
|
| [Hacker News](Hacker-News-da) | Hente en live-side, læse titler, links og scores, omdanne tekst til tal og finde maksimum |
|
||||||
|
| [Etik ved scraping](Scraping-Ethics-da) | Tjekke `robots.txt`, respektere ophavsret og logins og holde forespørgslerne sjældne |
|
||||||
|
| [Top 100 film](Top-100-Movies-da) | Scrape en rangeret liste, vende den om og skrive den til en fil |
|
||||||
|
| [Opsætning](Setup-da) | Arbejde i et virtuelt miljø med `pyproject.toml` og offline-tests |
|
||||||
|
|
||||||
|
## Ud over forelæsningerne
|
||||||
|
|
||||||
|
- **Parsing er adskilt fra hentning.** Parsing-funktionerne tager tekst, så testene bruger gemte sider og aldrig har brug for netværket.
|
||||||
|
- **Lag holder reglerne adskilt.** Rangeringsreglen kender hverken BeautifulSoup eller Requests.
|
||||||
|
- **Skærmbillederne laves af et script** (`tools/make_screenshots.py`), så de kan genskabes efter en ændring.
|
||||||
@@ -0,0 +1,57 @@
|
|||||||
|
[English](Hacker-News) · **Dansk** · [Bahasa Melayu](Hacker-News-ms)
|
||||||
|
|
||||||
|
# Scraping af Hacker News
|
||||||
|
|
||||||
|
Forelæsning: *Scraping af et live-websted*. Koden er `hacker_news.py` (parsing) og `http_client.py` (ét `requests.get` med timeout og `User-Agent`). Kommandoerne læser kursets statiske kopi af siden; `--source live` læser det rigtige websted, og `--source fixture` læser den gemte kopi uden netværk.
|
||||||
|
|
||||||
|
## Trin 1: se på siden
|
||||||
|
|
||||||
|
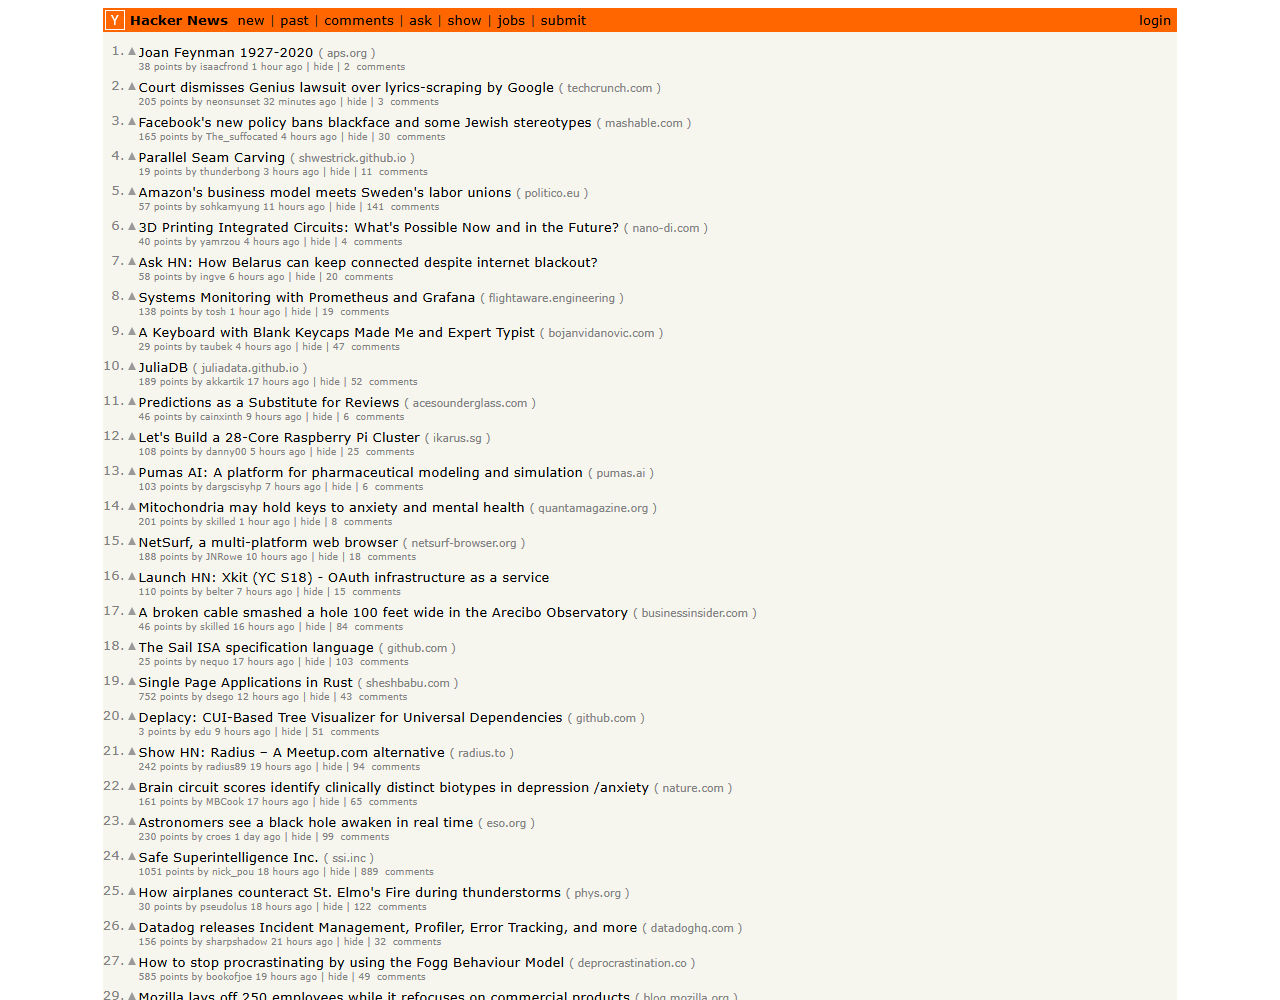
Siden viser historier med en titel, et link og en score.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** live-data er rigere end en lokal fil, men de kan ændre sig, så vi gemmer også en kopi til testene.
|
||||||
|
|
||||||
|
## Trin 2: undersøg markup
|
||||||
|
|
||||||
|
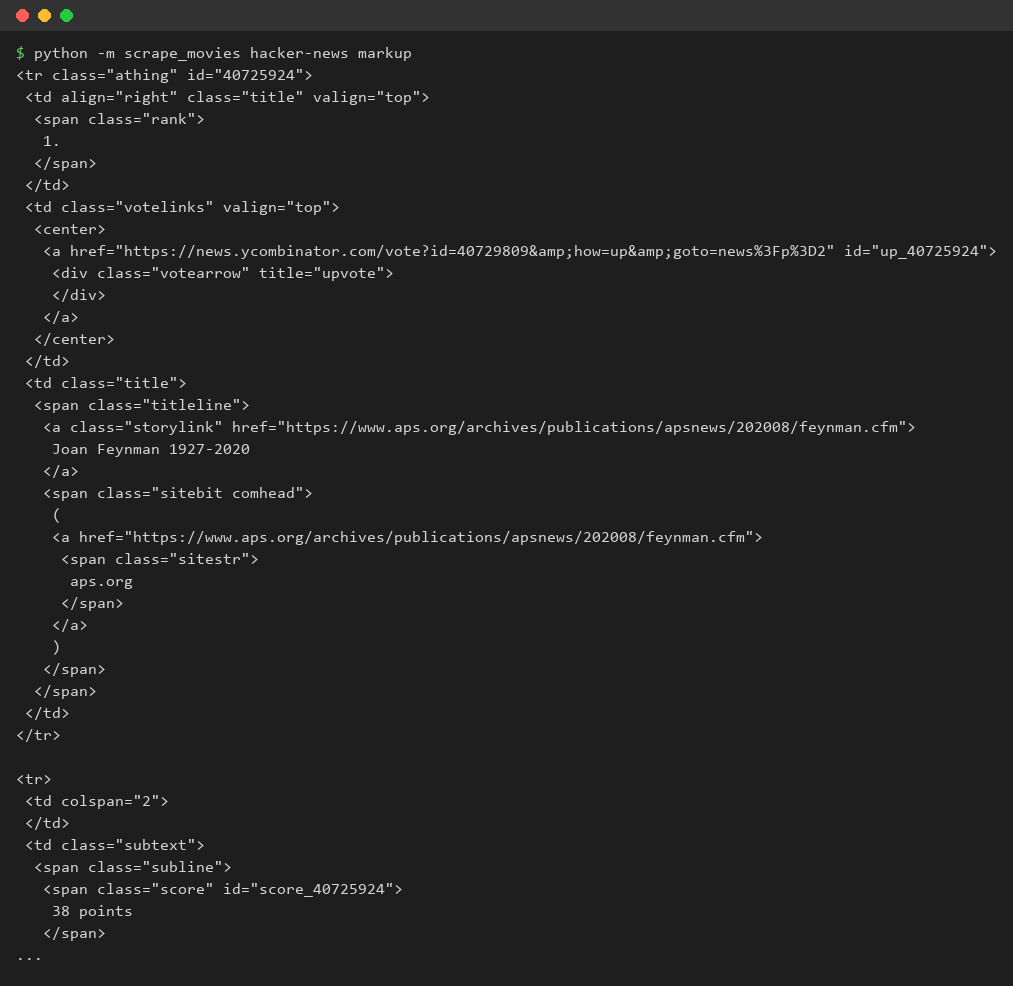
Browserens udviklerværktøjer viser tagsene: en række `tr.athing`, titellinket `.titleline > a` og en `span.score` i næste række.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** vi finder det rigtige tag ved at undersøge siden, før vi skriver kode.
|
||||||
|
|
||||||
|
## Trin 3: titler
|
||||||
|
|
||||||
|
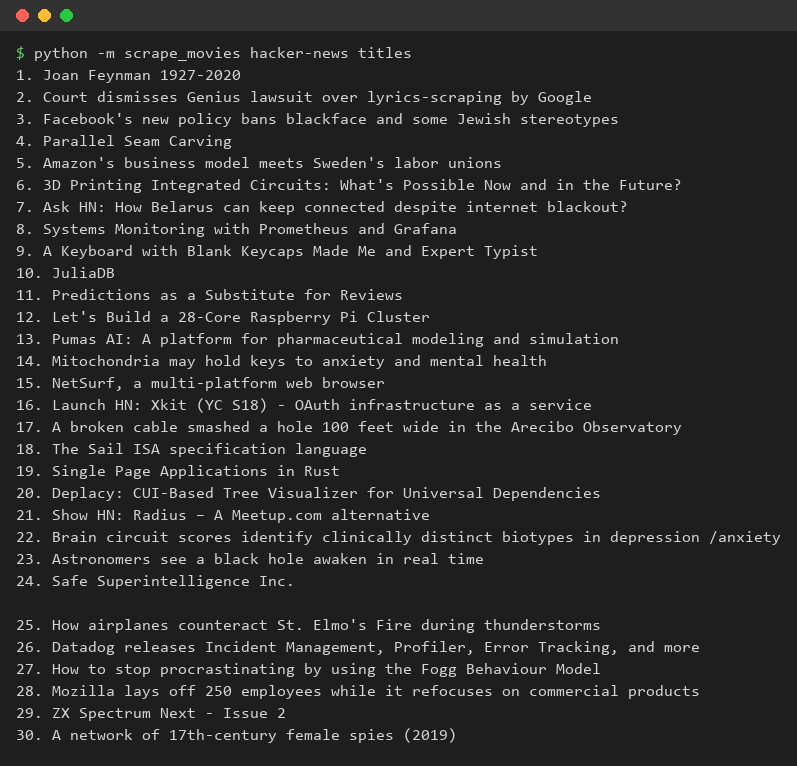
`find_all` på titellinkene og `get_text()`.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** en list comprehension gør mange tags til en almindelig liste af strenge.
|
||||||
|
|
||||||
|
## Trin 4: links
|
||||||
|
|
||||||
|
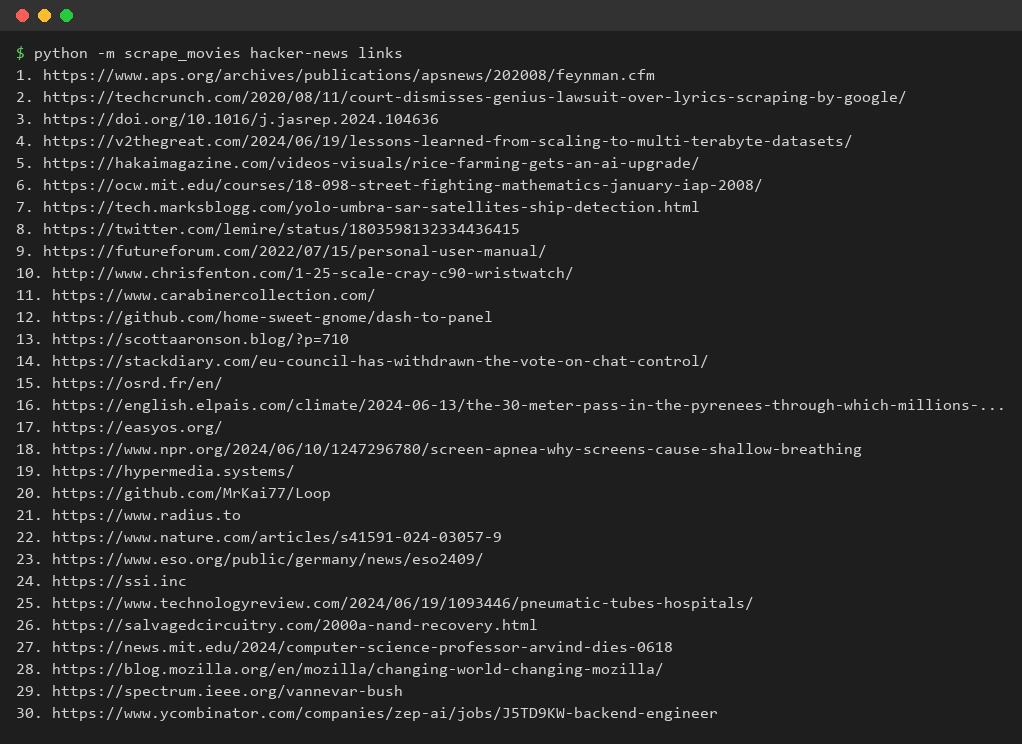
`get("href")` på de samme links.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** det samme element giver både tekst og attributværdier.
|
||||||
|
|
||||||
|
## Trin 5: upvotes
|
||||||
|
|
||||||
|
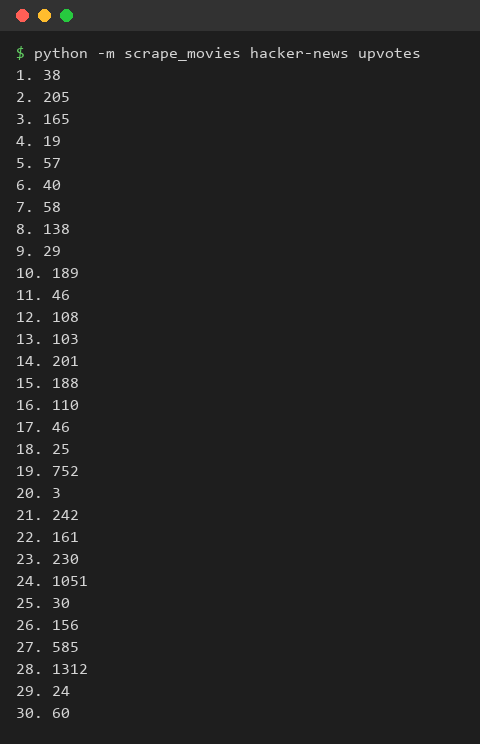
Teksten `38 points` deles op og omdannes med `int()`.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** scrapet tekst skal omdannes til tal, før den kan sammenlignes.
|
||||||
|
|
||||||
|
## Trin 6: den øverste historie
|
||||||
|
|
||||||
|
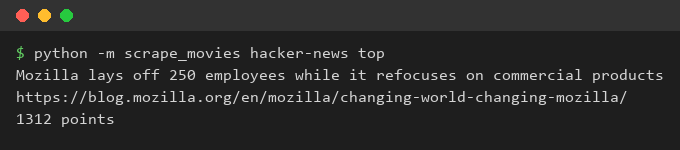
`max` over upvotes finder den mest populære artikel.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** når data er rene, besvarer almindelig Python spørgsmål om dem.
|
||||||
|
|
||||||
|
## Hvad vi lærte
|
||||||
|
|
||||||
|
Vi kan hente en side med Requests, finde rækkerne, læse titler, links og scores, omdanne dem til brugbare typer og besvare et spørgsmål om data.
|
||||||
@@ -0,0 +1,23 @@
|
|||||||
|
[English](Home) · **Dansk** · [Bahasa Melayu](Home-ms)
|
||||||
|
|
||||||
|
# scrape-movies wiki
|
||||||
|
|
||||||
|
Dag 45 af Udemys "100 Days of Code: The Complete Python Pro Bootcamp" handler om web scraping med Requests og BeautifulSoup. Dette repository gengiver hvert trin fra forelæsningerne som testet Python-kode. Wikien viser hvert trin med et skærmbillede og forklarer, hvad vi lærte af det.
|
||||||
|
|
||||||
|
## Sider
|
||||||
|
|
||||||
|
| Side | Forelæsning | Indhold |
|
||||||
|
| --- | --- | --- |
|
||||||
|
| [Opsætning](Setup-da) | - | Opret `.venv`, installér og kør testene |
|
||||||
|
| [Parsing af HTML](Parsing-HTML-da) | Parsing af HTML og at lave suppe; find og vælg elementer | Fem trin med skærmbilleder |
|
||||||
|
| [Hacker News](Hacker-News-da) | Scraping af et live-websted | Seks trin med skærmbilleder |
|
||||||
|
| [Etik ved scraping](Scraping-Ethics-da) | Er web scraping lovligt og etisk? | Reglerne vi følger, med et skærmbillede af `robots.txt` |
|
||||||
|
| [Top 100 film](Top-100-Movies-da) | Projektet med de 100 film | Seks trin og `movies.txt` |
|
||||||
|
| [Hvad vi lærte](Gains-da) | Alle forelæsninger | Et kort resumé af færdighederne |
|
||||||
|
|
||||||
|
## Til hvem
|
||||||
|
|
||||||
|
- **Kursister:** læsbar, kørbar kode med opgavens idéer; sammenlign den med din egen løsning.
|
||||||
|
- **Besøgende:** et lille eksempel med tests og kun to afhængigheder ved kørsel, `requests` og `beautifulsoup4`.
|
||||||
|
|
||||||
|
Koden og dokumenterne findes i [repositoryet](https://git.tirsystem.com/Tirsvad-Udemy-100-days-of-code/045-scrape-movies).
|
||||||
@@ -0,0 +1,49 @@
|
|||||||
|
[English](Parsing-HTML) · **Dansk** · [Bahasa Melayu](Parsing-HTML-ms)
|
||||||
|
|
||||||
|
# Parsing af HTML
|
||||||
|
|
||||||
|
Forelæsninger: *Parsing af HTML og at lave suppe* og *Find og vælg elementer*. Eksempelsiden er `tests/fixtures/website.html`; koden er `soup_basics.py`.
|
||||||
|
|
||||||
|
## Trin 1: lav en suppe og læs titlen
|
||||||
|
|
||||||
|
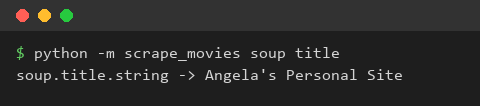
`BeautifulSoup(html, "html.parser")` gør HTML-teksten til et suppe-objekt. `soup.title.string` er teksten i title-tagget.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** HTML-tekst bliver til et objekt, vi kan navigere i, og et tag nås med almindelig attributadgang.
|
||||||
|
|
||||||
|
## Trin 2: prettify
|
||||||
|
|
||||||
|
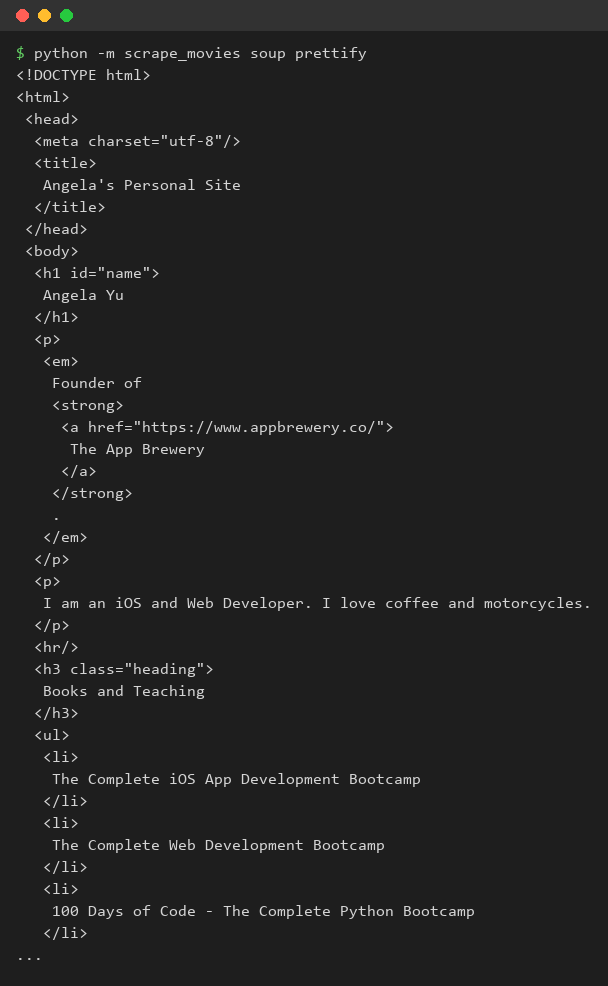
`soup.prettify()` skriver dokumentet med ét tag pr. linje, så indlejringen bliver synlig.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** når vi først læser strukturen, ved vi, hvad vi skal spørge om.
|
||||||
|
|
||||||
|
## Trin 3: find alle tags
|
||||||
|
|
||||||
|
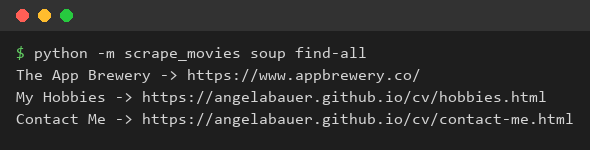
`find_all("a")` giver alle links. I en løkke giver `get_text()` teksten og `get("href")` adressen.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** ét kald finder mange elementer, og en løkke gør dem til data.
|
||||||
|
|
||||||
|
## Trin 4: find med id og klasse
|
||||||
|
|
||||||
|
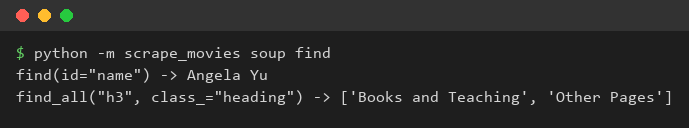
`find(id="name")` finder ét tag via dets id. `find_all("h3", class_="heading")` filtrerer på tag og klasse; nøgleordet er `class_`, fordi `class` er et reserveret ord i Python.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** attributter indsnævrer en søgning, og vi undgår sammenstød med reserverede ord.
|
||||||
|
|
||||||
|
## Trin 5: CSS-selektorer
|
||||||
|
|
||||||
|
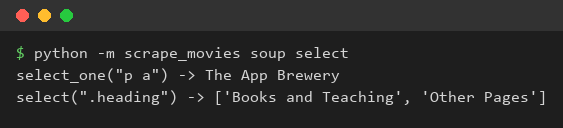
`select_one("p a")` og `select(".heading")` bruger de samme selektorer som CSS, så indlejrede elementer nås i ét udtryk.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** CSS-selektorer er den korteste måde at beskrive, hvor et element sidder i dokumentet.
|
||||||
|
|
||||||
|
## Hvad vi lærte
|
||||||
|
|
||||||
|
Vi kan læse en HTML-fil ind i BeautifulSoup, se dens struktur og udvælge enkelte eller mange elementer via tag, id, klasse eller CSS-selektor.
|
||||||
@@ -0,0 +1,24 @@
|
|||||||
|
[English](Scraping-Ethics) · **Dansk** · [Bahasa Melayu](Scraping-Ethics-ms)
|
||||||
|
|
||||||
|
# Er web scraping lovligt og etisk?
|
||||||
|
|
||||||
|
Forelæsning: *Web scrapings juridiske og etiske side*. Dette er et resumé med egne ord og ikke juridisk rådgivning.
|
||||||
|
|
||||||
|
## Trin 1: læs robots.txt først
|
||||||
|
|
||||||
|
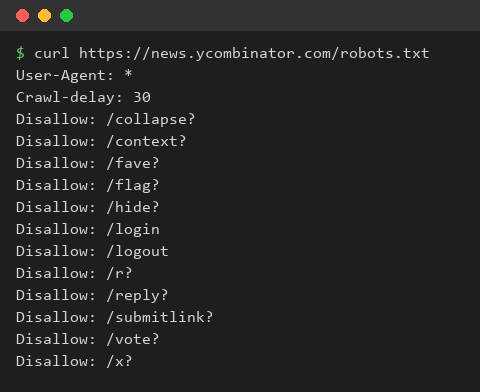
Et websteds `robots.txt` fortæller, hvad det tillader. Hacker News forbyder nogle stier og beder om en pause på 30 sekunder mellem forespørgsler.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** vi tjekker reglerne, før vi scraper, og vi holder forespørgslerne sjældne: dette projekt henter én side pr. kørsel.
|
||||||
|
|
||||||
|
## Reglerne vi følger
|
||||||
|
|
||||||
|
- Offentlige data uden ophavsret må generelt gerne læses. Sagerne Genius mod Google og hiQ mod LinkedIn viser, at grænsen ikke er enkel.
|
||||||
|
- Indhold med ophavsret, som videoer eller blogindlæg, må ikke kopieres. Data bag et login er omfattet af webstedets brugeraftale.
|
||||||
|
- Kommerciel brug af scrapede data kan føre til dyre tvister, selv når selve scrapingen var tilladt.
|
||||||
|
- Foretræk et officielt API, respektér `robots.txt`, send en `User-Agent`, og send højst én forespørgsel i minuttet.
|
||||||
|
|
||||||
|
## Hvad vi lærte
|
||||||
|
|
||||||
|
Scraping er en teknisk færdighed med juridiske og etiske grænser. At kende grænserne er en del af at gøre det godt.
|
||||||
@@ -0,0 +1,38 @@
|
|||||||
|
[English](Setup) · **Dansk** · [Bahasa Melayu](Setup-ms)
|
||||||
|
|
||||||
|
# Opsætning
|
||||||
|
|
||||||
|
Du skal bruge Python 3.13 eller nyere. Alt nedenfor køres fra repositoryets rodmappe.
|
||||||
|
|
||||||
|
## Opret det virtuelle miljø
|
||||||
|
|
||||||
|
```powershell
|
||||||
|
python -m venv .venv
|
||||||
|
.venv\Scripts\Activate.ps1
|
||||||
|
python -m pip install --upgrade pip
|
||||||
|
python -m pip install -e ".[dev]"
|
||||||
|
```
|
||||||
|
|
||||||
|
På Linux og macOS bruges `python3 -m venv .venv` og `source .venv/bin/activate`.
|
||||||
|
|
||||||
|
## Kør et trin fra forelæsningen
|
||||||
|
|
||||||
|
```bash
|
||||||
|
python -m scrape_movies soup title
|
||||||
|
python -m scrape_movies hacker-news top
|
||||||
|
python -m scrape_movies movies write
|
||||||
|
```
|
||||||
|
|
||||||
|
## Kør testene
|
||||||
|
|
||||||
|
```bash
|
||||||
|
python -m pytest
|
||||||
|
```
|
||||||
|
|
||||||
|
Testene bruger gemte sider fra `tests/fixtures/` og rører aldrig netværket.
|
||||||
|
|
||||||
|
## Hvad vi lærte
|
||||||
|
|
||||||
|
- Et virtuelt miljø holder projektets pakker adskilt fra systemets Python.
|
||||||
|
- `pyproject.toml` er det ene sted for Python-versionen, afhængighederne og værktøjsindstillingerne.
|
||||||
|
- Tests, der kører offline, giver det samme resultat på alle maskiner.
|
||||||
@@ -0,0 +1,59 @@
|
|||||||
|
[English](Top-100-Movies) · **Dansk** · [Bahasa Melayu](Top-100-Movies-ms)
|
||||||
|
|
||||||
|
# Top 100 film
|
||||||
|
|
||||||
|
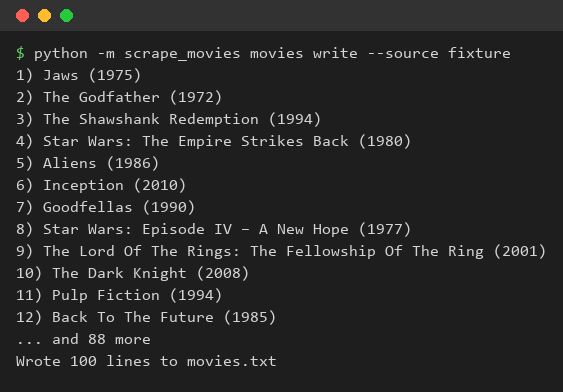
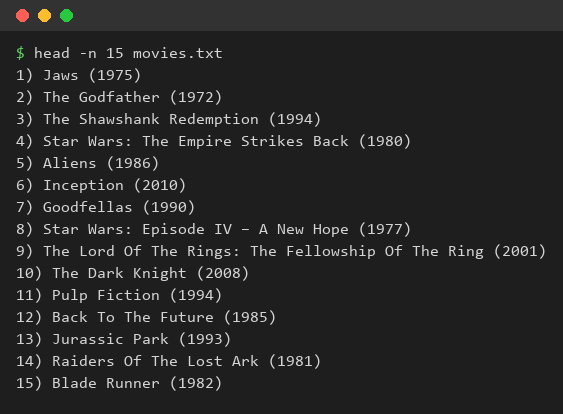
Forelæsning: *Projektet med de 100 film*. Målet er `movies.txt` med titlerne nummereret fra `1)` og opefter. Koden er `empire_movies.py` (parsing), `movie.py` (vend om og nummerér) og `movie_file.py` (skrivning).
|
||||||
|
|
||||||
|
## Trin 1: vælg siden
|
||||||
|
|
||||||
|
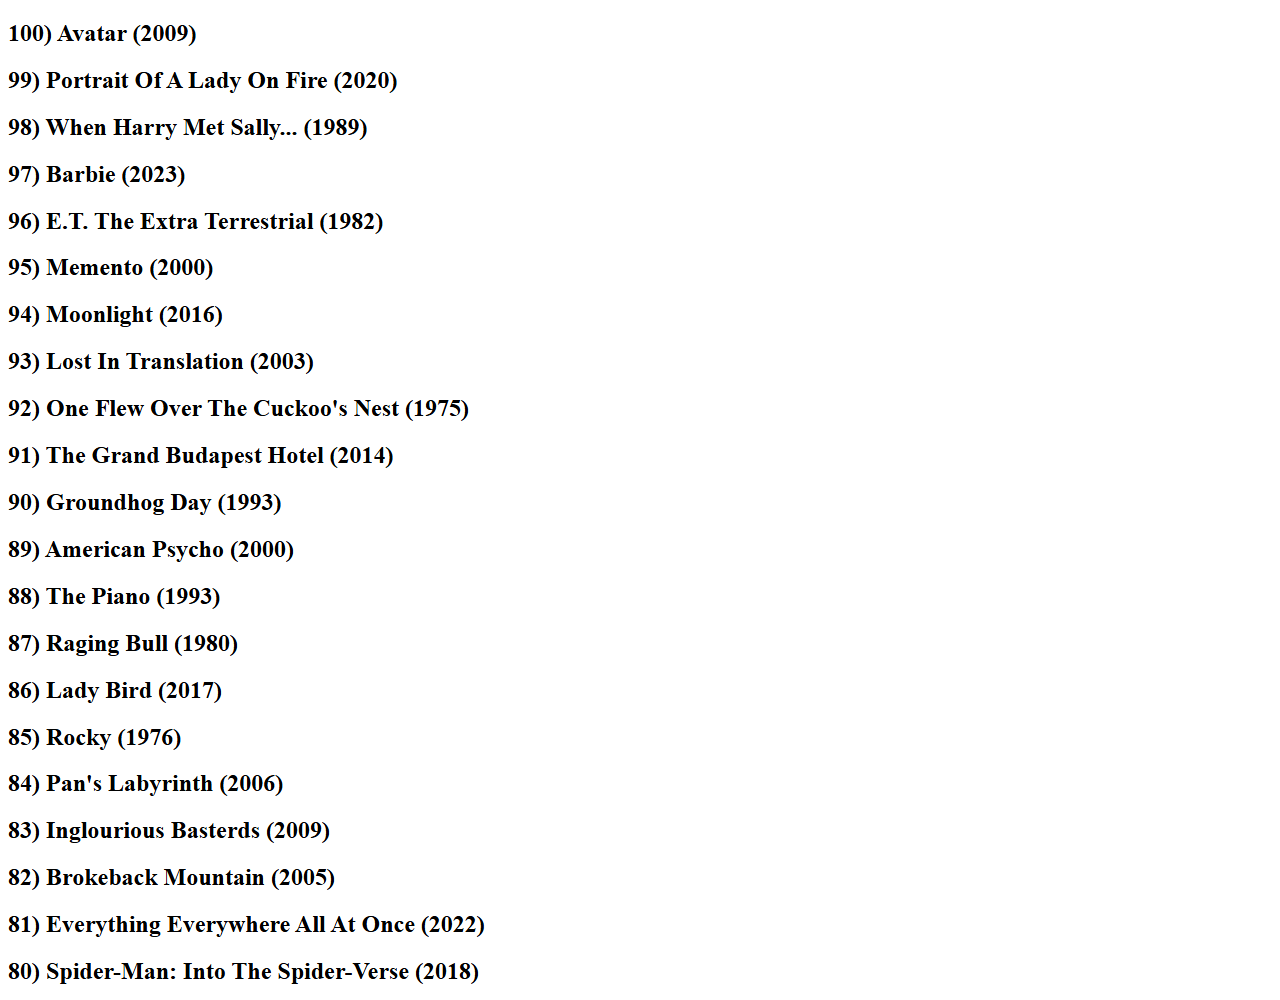
Opgaven fastlåser et øjebliksbillede fra Internet Archive af Empires liste, fordi levende websteder ændrer sig. Skærmbilledet viser sidens gemte overskrifter.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** et fastlåst øjebliksbillede gør en scraper gentagelig.
|
||||||
|
|
||||||
|
## Trin 2: undersøg markup
|
||||||
|
|
||||||
|
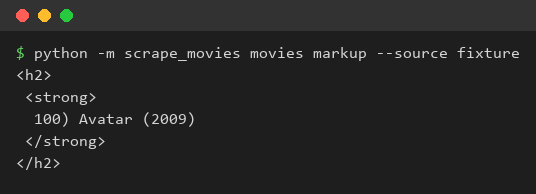
Siden fra 2020 har `<h3 class="title">`; den nuværende side har `<h2><strong>`-overskrifter, der begynder med en placering.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** når et websted ændrer markup, skal parseren følge med, så vi dækker begge opbygninger.
|
||||||
|
|
||||||
|
## Trin 3: titler i sidens rækkefølge
|
||||||
|
|
||||||
|
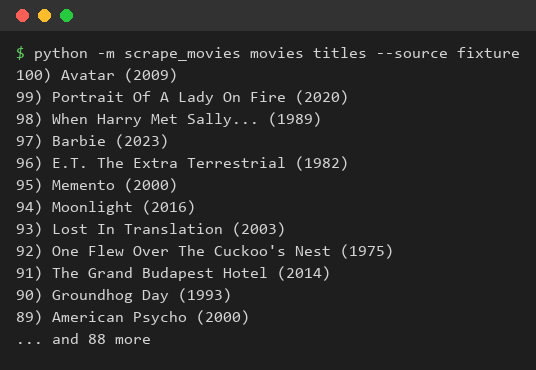
`select("h3.title")` og en list comprehension over `get_text()`. Siden tæller ned fra 100.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** en list comprehension er den kompakte måde at samle tekst fra mange tags.
|
||||||
|
|
||||||
|
## Trin 4: vend listen om
|
||||||
|
|
||||||
|
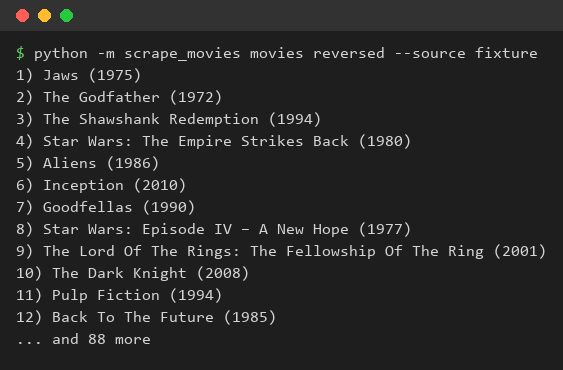
`titles[::-1]` får listen til at tælle op fra 1.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** udsnit med negativt trin vender en liste om i ét udtryk.
|
||||||
|
|
||||||
|
## Trin 5: skriv movies.txt
|
||||||
|
|
||||||
|
En `with open(...)`-blok skriver én titel pr. linje.
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** kontekstmanageren lukker filen for os, og den samme kørsel giver altid den samme fil.
|
||||||
|
|
||||||
|
## Trin 6: resultatet
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**Hvad vi lærte:** en personlig film-seerliste fra et websted, klar til at vælge en film tilfældigt.
|
||||||
|
|
||||||
|
## Note om data
|
||||||
|
|
||||||
|
`movies.txt` blev lavet ud fra Empires nuværende liste den 2026-10-28, så placeringerne afviger fra listen fra 2020 i forelæsningen. Internet Archive svarede `429 Too Many Requests`, mens vi byggede projektet, så opbygningen af øjebliksbilledet er dækket af et håndskrevet eksempel i testene.
|
||||||
|
|
||||||
|
## Hvad vi lærte
|
||||||
|
|
||||||
|
Vi kan scrape en rangeret liste, lægge den i den rækkefølge vi vil have og gemme den i en fil.
|
||||||
Reference in New Issue
Block a user