MIL-005: wiki in English, Danish and Bahasa Malaysia #39
@@ -0,0 +1,17 @@
|
||||
[English](Gains) · [Dansk](Gains-da) · **Bahasa Melayu**
|
||||
|
||||
# Apa yang kita pelajari
|
||||
|
||||
| Kuliah | Apa yang boleh kita lakukan sekarang |
|
||||
| --- | --- |
|
||||
| [Menghurai HTML](Parsing-HTML-ms) | Membuat sup, membaca strukturnya dan memilih elemen mengikut tag, id, kelas atau pemilih CSS |
|
||||
| [Hacker News](Hacker-News-ms) | Mengambil halaman langsung, membaca tajuk, pautan dan skor, menukar teks kepada nombor dan mencari nilai maksimum |
|
||||
| [Etika mengikis web](Scraping-Ethics-ms) | Menyemak `robots.txt`, menghormati hak cipta dan log masuk, menjarangkan permintaan |
|
||||
| [100 filem terbaik](Top-100-Movies-ms) | Mengikis senarai berkedudukan, membalikkannya dan menulisnya ke fail |
|
||||
| [Persediaan](Setup-ms) | Bekerja dalam persekitaran maya dengan `pyproject.toml` dan ujian tanpa talian |
|
||||
|
||||
## Selain kuliah
|
||||
|
||||
- **Penghuraian dipisahkan daripada pengambilan.** Fungsi penghuraian menerima teks, jadi ujian menggunakan halaman tersimpan dan tidak memerlukan rangkaian.
|
||||
- **Lapisan mengasingkan peraturan.** Peraturan kedudukan tidak mengetahui BeautifulSoup atau Requests.
|
||||
- **Tangkapan skrin dibuat oleh skrip** (`tools/make_screenshots.py`), jadi ia boleh dijana semula selepas perubahan.
|
||||
@@ -0,0 +1,57 @@
|
||||
[English](Hacker-News) · [Dansk](Hacker-News-da) · **Bahasa Melayu**
|
||||
|
||||
# Mengikis Hacker News
|
||||
|
||||
Kuliah: *Mengikis laman web langsung*. Kodnya ialah `hacker_news.py` (penghuraian) dan `http_client.py` (satu `requests.get` dengan had masa dan `User-Agent`). Arahan membaca salinan statik halaman daripada kursus; `--source live` membaca laman sebenar dan `--source fixture` membaca salinan tersimpan tanpa rangkaian.
|
||||
|
||||
## Langkah 1: lihat halaman
|
||||
|
||||
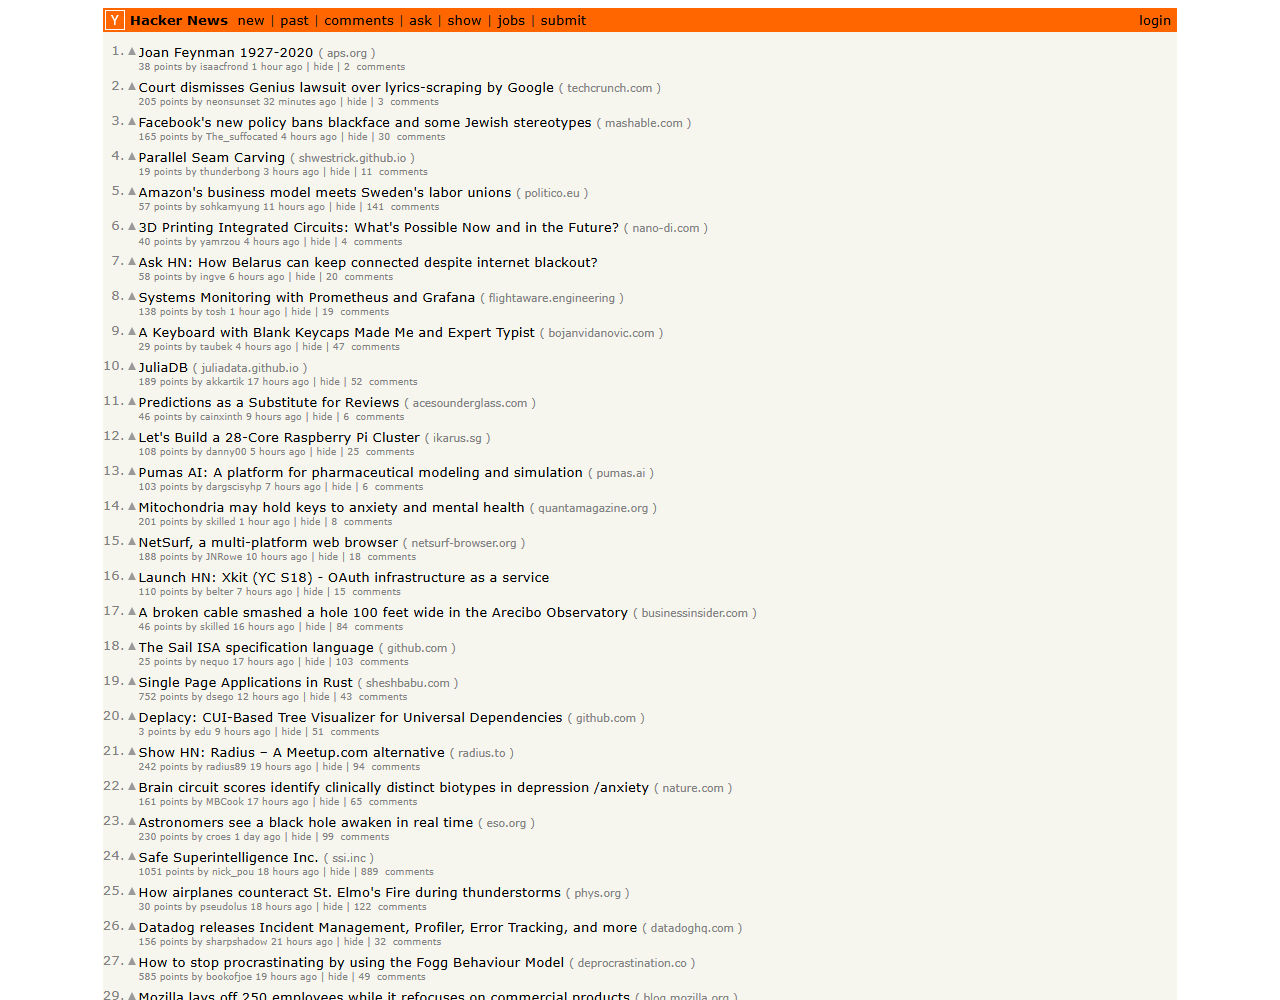
Halaman menyenaraikan berita dengan tajuk, pautan dan skor.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** data langsung lebih kaya daripada fail tempatan, tetapi boleh berubah, jadi kita juga menyimpan salinan untuk ujian.
|
||||
|
||||
## Langkah 2: periksa markup
|
||||
|
||||
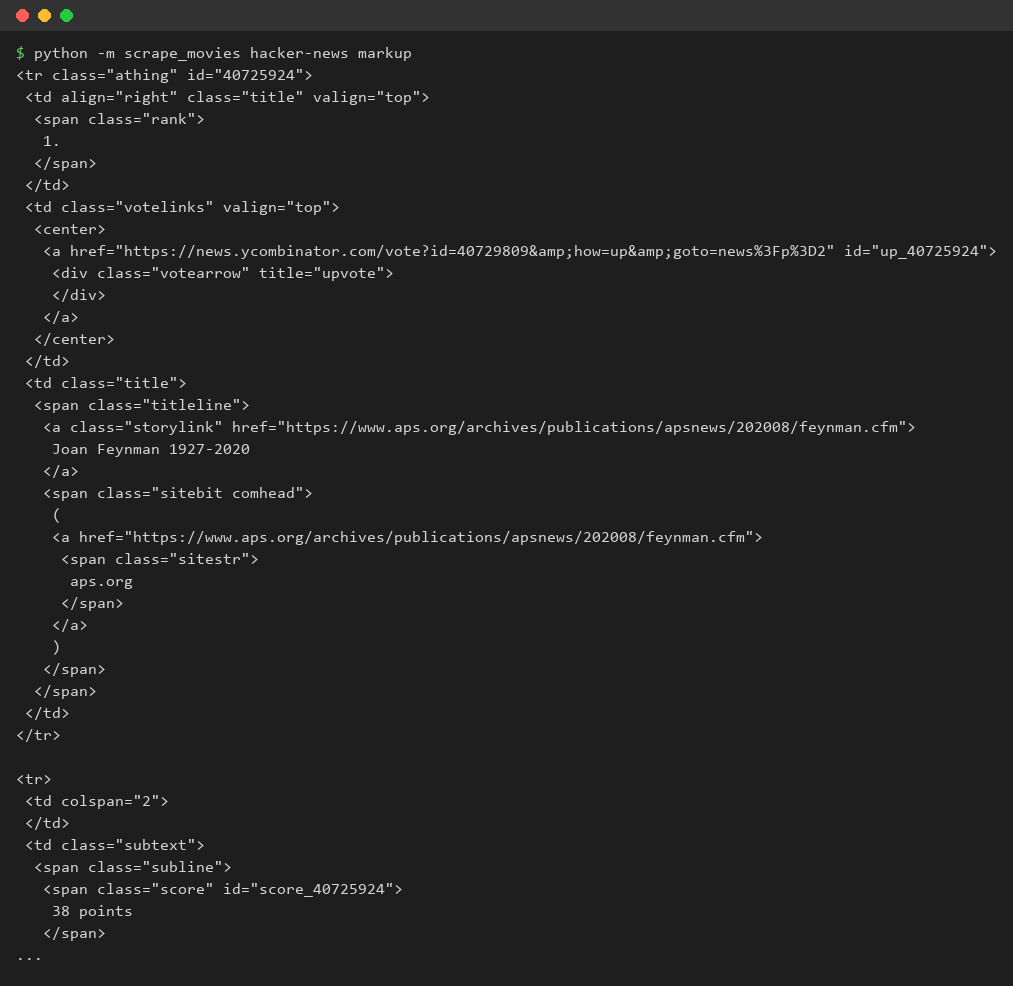
Alat pembangun pelayar menunjukkan tag: baris `tr.athing`, pautan tajuk `.titleline > a` dan `span.score` pada baris seterusnya.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** kita menemui tag yang betul dengan memeriksa halaman sebelum menulis kod.
|
||||
|
||||
## Langkah 3: tajuk
|
||||
|
||||
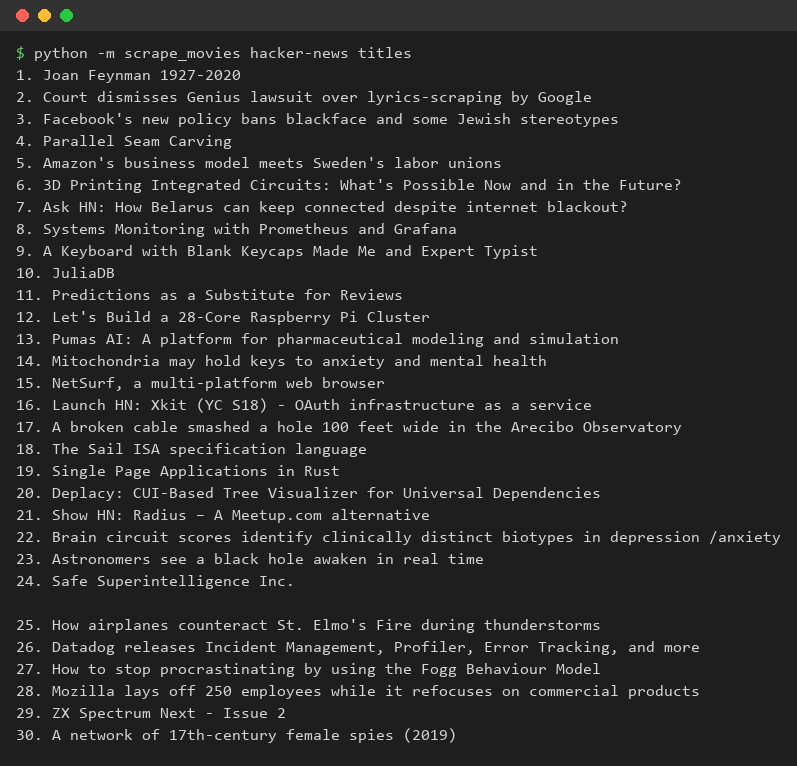
`find_all` pada pautan tajuk dan `get_text()`.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** list comprehension menukar banyak tag menjadi senarai rentetan biasa.
|
||||
|
||||
## Langkah 4: pautan
|
||||
|
||||
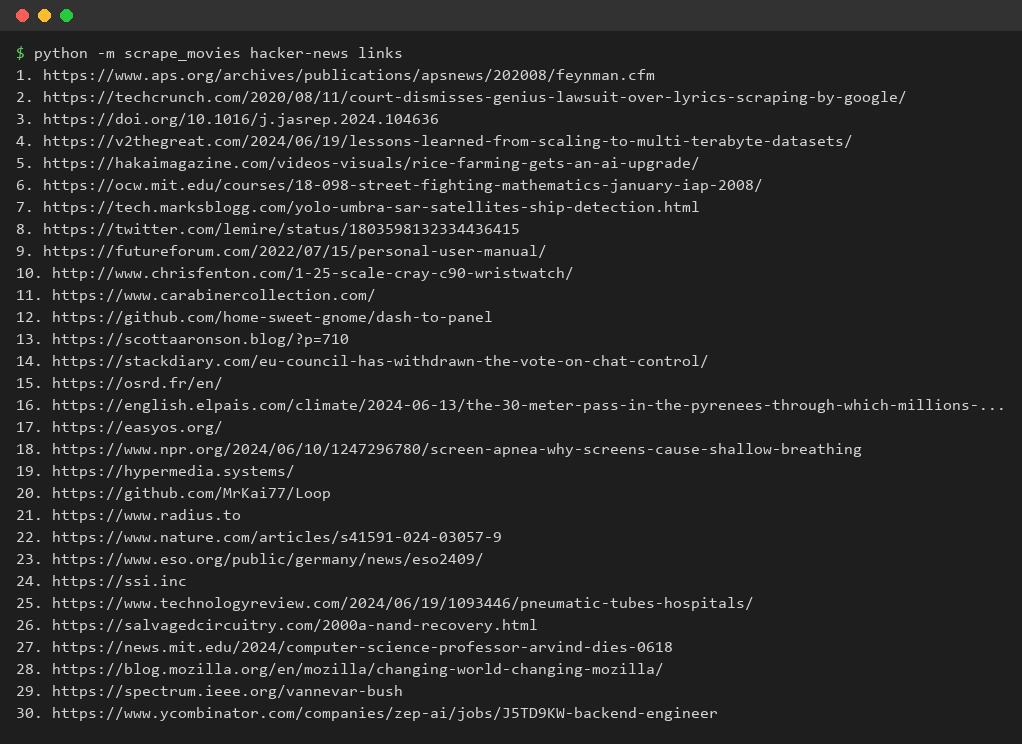
`get("href")` pada anchor yang sama.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** elemen yang sama memberi teks dan nilai atribut.
|
||||
|
||||
## Langkah 5: undian
|
||||
|
||||
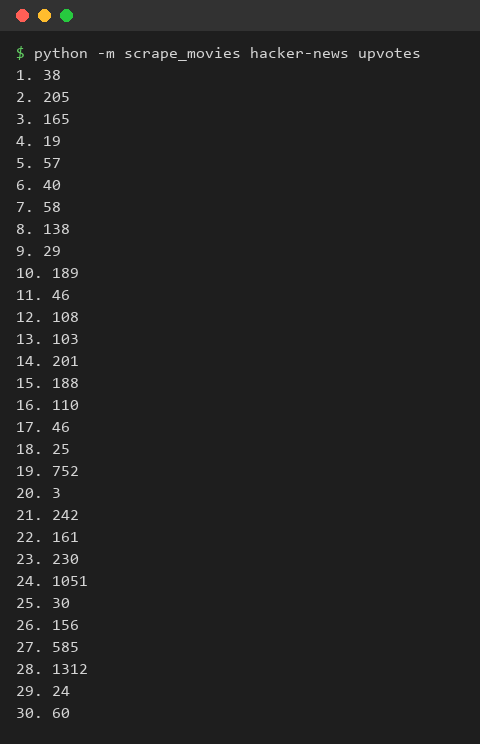
Teks `38 points` dipecahkan dan ditukar dengan `int()`.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** teks yang dikikis mesti ditukar kepada nombor sebelum boleh dibandingkan.
|
||||
|
||||
## Langkah 6: berita teratas
|
||||
|
||||
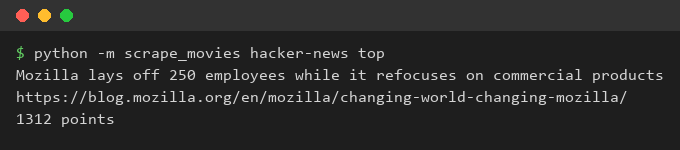
`max` pada undian mencari artikel paling popular.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** apabila data sudah bersih, Python biasa menjawab soalan tentangnya.
|
||||
|
||||
## Apa yang kita pelajari
|
||||
|
||||
Kita boleh mengambil halaman dengan Requests, menemui baris, membaca tajuk, pautan dan skor, menukarnya kepada jenis yang berguna dan menjawab soalan tentang data.
|
||||
@@ -0,0 +1,23 @@
|
||||
[English](Home) · [Dansk](Home-da) · **Bahasa Melayu**
|
||||
|
||||
# Wiki scrape-movies
|
||||
|
||||
Hari ke-45 kursus Udemy "100 Days of Code: The Complete Python Pro Bootcamp" membincangkan pengikisan web (web scraping) dengan Requests dan BeautifulSoup. Repositori ini menghasilkan semula setiap langkah kuliah sebagai kod Python yang diuji. Wiki ini menunjukkan setiap langkah dengan tangkapan skrin dan menerangkan apa yang kita pelajari daripadanya.
|
||||
|
||||
## Halaman
|
||||
|
||||
| Halaman | Kuliah | Kandungan |
|
||||
| --- | --- | --- |
|
||||
| [Persediaan](Setup-ms) | - | Cipta `.venv`, pasang dan jalankan ujian |
|
||||
| [Menghurai HTML](Parsing-HTML-ms) | Menghurai HTML dan membuat sup; mencari dan memilih elemen | Lima langkah dengan tangkapan skrin |
|
||||
| [Hacker News](Hacker-News-ms) | Mengikis laman web langsung | Enam langkah dengan tangkapan skrin |
|
||||
| [Etika mengikis web](Scraping-Ethics-ms) | Adakah pengikisan web sah dan beretika? | Peraturan yang kita ikut, dengan tangkapan skrin `robots.txt` |
|
||||
| [100 filem terbaik](Top-100-Movies-ms) | Projek 100 filem | Enam langkah dan `movies.txt` |
|
||||
| [Apa yang kita pelajari](Gains-ms) | Semua kuliah | Ringkasan kemahiran |
|
||||
|
||||
## Untuk siapa
|
||||
|
||||
- **Peserta kursus:** kod yang mudah dibaca dan boleh dijalankan dengan idea tugasan; bandingkan dengan penyelesaian anda sendiri.
|
||||
- **Pelawat:** contoh kecil dengan ujian dan hanya dua kebergantungan semasa larian, `requests` dan `beautifulsoup4`.
|
||||
|
||||
Kod dan dokumen terdapat dalam [repositori](https://git.tirsystem.com/Tirsvad-Udemy-100-days-of-code/045-scrape-movies).
|
||||
@@ -0,0 +1,49 @@
|
||||
[English](Parsing-HTML) · [Dansk](Parsing-HTML-da) · **Bahasa Melayu**
|
||||
|
||||
# Menghurai HTML
|
||||
|
||||
Kuliah: *Menghurai HTML dan Membuat Sup* dan *Mencari dan Memilih Elemen*. Halaman contoh ialah `tests/fixtures/website.html`; kodnya ialah `soup_basics.py`.
|
||||
|
||||
## Langkah 1: cipta sup dan baca tajuk
|
||||
|
||||
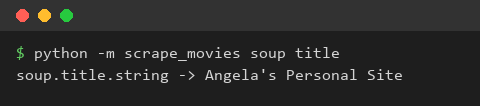
`BeautifulSoup(html, "html.parser")` menukar teks HTML menjadi objek sup. `soup.title.string` ialah teks dalam tag title.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** teks HTML menjadi objek yang boleh dilayari, dan satu tag dicapai dengan akses atribut biasa.
|
||||
|
||||
## Langkah 2: prettify
|
||||
|
||||
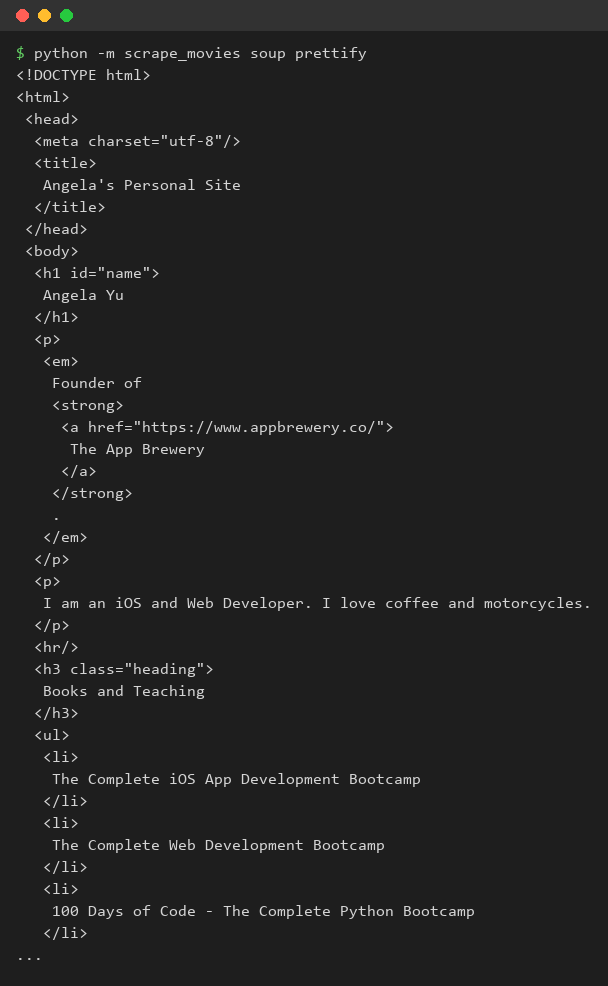
`soup.prettify()` menulis dokumen dengan satu tag setiap baris supaya sarangan kelihatan.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** dengan membaca struktur dahulu, kita tahu apa yang perlu diminta.
|
||||
|
||||
## Langkah 3: cari semua tag
|
||||
|
||||
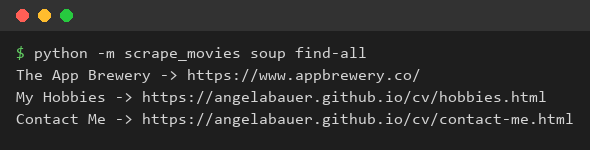
`find_all("a")` memberi semua pautan. Dalam gelung, `get_text()` memberi teks dan `get("href")` memberi alamat.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** satu panggilan menemui banyak elemen, dan gelung menukarnya menjadi data.
|
||||
|
||||
## Langkah 4: cari mengikut id dan kelas
|
||||
|
||||
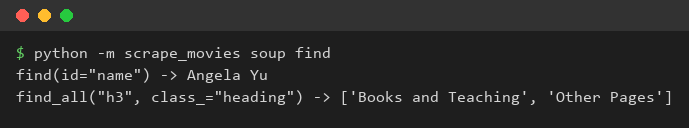
`find(id="name")` mencari satu tag mengikut id. `find_all("h3", class_="heading")` menapis mengikut tag dan kelas; kata kuncinya ialah `class_` kerana `class` ialah kata kunci Python.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** atribut mengecilkan carian, dan kita mengelak pertembungan dengan kata terpelihara.
|
||||
|
||||
## Langkah 5: pemilih CSS
|
||||
|
||||
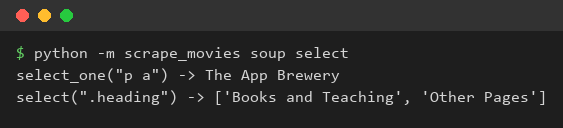
`select_one("p a")` dan `select(".heading")` menggunakan pemilih yang sama seperti CSS, jadi elemen bersarang dicapai dalam satu ungkapan.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** pemilih CSS ialah cara paling ringkas untuk menerangkan kedudukan elemen dalam dokumen.
|
||||
|
||||
## Apa yang kita pelajari
|
||||
|
||||
Kita boleh membaca fail HTML ke dalam BeautifulSoup, melihat strukturnya dan memilih satu atau banyak elemen mengikut tag, id, kelas atau pemilih CSS.
|
||||
@@ -0,0 +1,24 @@
|
||||
[English](Scraping-Ethics) · [Dansk](Scraping-Ethics-da) · **Bahasa Melayu**
|
||||
|
||||
# Adakah pengikisan web sah dan beretika?
|
||||
|
||||
Kuliah: *Aspek undang-undang dan etika pengikisan web*. Ini ringkasan dengan kata-kata sendiri dan bukan nasihat undang-undang.
|
||||
|
||||
## Langkah 1: baca robots.txt dahulu
|
||||
|
||||
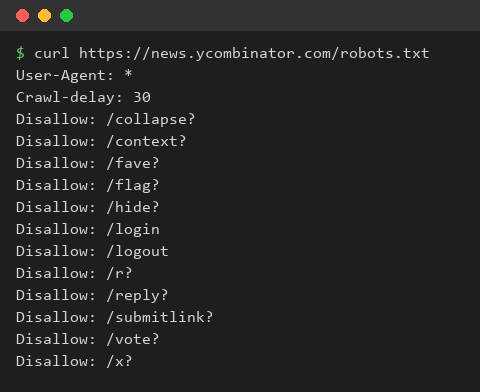
`robots.txt` sesebuah laman menyatakan apa yang dibenarkan. Hacker News melarang beberapa laluan dan meminta jeda 30 saat antara permintaan.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** kita menyemak peraturan sebelum mengikis dan menjarangkan permintaan: projek ini mengambil satu halaman setiap larian.
|
||||
|
||||
## Peraturan yang kita ikut
|
||||
|
||||
- Data awam yang tidak dilindungi hak cipta umumnya boleh dibaca. Kes Genius lawan Google dan hiQ lawan LinkedIn menunjukkan bahawa garisnya tidak mudah.
|
||||
- Kandungan berhak cipta, seperti video atau catatan blog, tidak boleh disalin. Data di sebalik log masuk dilindungi perjanjian pengguna laman itu.
|
||||
- Penggunaan komersial data yang dikikis boleh membawa pertikaian yang mahal walaupun pengikisan itu sendiri dibenarkan.
|
||||
- Pilih API rasmi jika ada, hormati `robots.txt`, hantar `User-Agent` dan jangan hantar lebih daripada satu permintaan seminit.
|
||||
|
||||
## Apa yang kita pelajari
|
||||
|
||||
Pengikisan web ialah kemahiran teknikal yang mempunyai had undang-undang dan etika. Mengetahui had itu sebahagian daripada melakukannya dengan baik.
|
||||
@@ -0,0 +1,38 @@
|
||||
[English](Setup) · [Dansk](Setup-da) · **Bahasa Melayu**
|
||||
|
||||
# Persediaan
|
||||
|
||||
Anda memerlukan Python 3.13 atau lebih baharu. Semua arahan di bawah dijalankan dari akar repositori.
|
||||
|
||||
## Cipta persekitaran maya
|
||||
|
||||
```powershell
|
||||
python -m venv .venv
|
||||
.venv\Scripts\Activate.ps1
|
||||
python -m pip install --upgrade pip
|
||||
python -m pip install -e ".[dev]"
|
||||
```
|
||||
|
||||
Di Linux dan macOS gunakan `python3 -m venv .venv` dan `source .venv/bin/activate`.
|
||||
|
||||
## Jalankan satu langkah kuliah
|
||||
|
||||
```bash
|
||||
python -m scrape_movies soup title
|
||||
python -m scrape_movies hacker-news top
|
||||
python -m scrape_movies movies write
|
||||
```
|
||||
|
||||
## Jalankan ujian
|
||||
|
||||
```bash
|
||||
python -m pytest
|
||||
```
|
||||
|
||||
Ujian menggunakan halaman tersimpan dalam `tests/fixtures/` dan tidak pernah menyentuh rangkaian.
|
||||
|
||||
## Apa yang kita pelajari
|
||||
|
||||
- Persekitaran maya mengasingkan pakej projek daripada Python sistem.
|
||||
- `pyproject.toml` ialah satu tempat untuk versi Python, kebergantungan dan tetapan alat.
|
||||
- Ujian yang berjalan tanpa talian memberi keputusan yang sama pada setiap mesin.
|
||||
@@ -0,0 +1,59 @@
|
||||
[English](Top-100-Movies) · [Dansk](Top-100-Movies-da) · **Bahasa Melayu**
|
||||
|
||||
# 100 filem terbaik
|
||||
|
||||
Kuliah: *Projek 100 filem*. Matlamatnya ialah `movies.txt` dengan tajuk bernombor bermula dari `1)`. Kodnya ialah `empire_movies.py` (penghuraian), `movie.py` (terbalikkan dan nomborkan) dan `movie_file.py` (penulisan).
|
||||
|
||||
## Langkah 1: pilih halaman
|
||||
|
||||
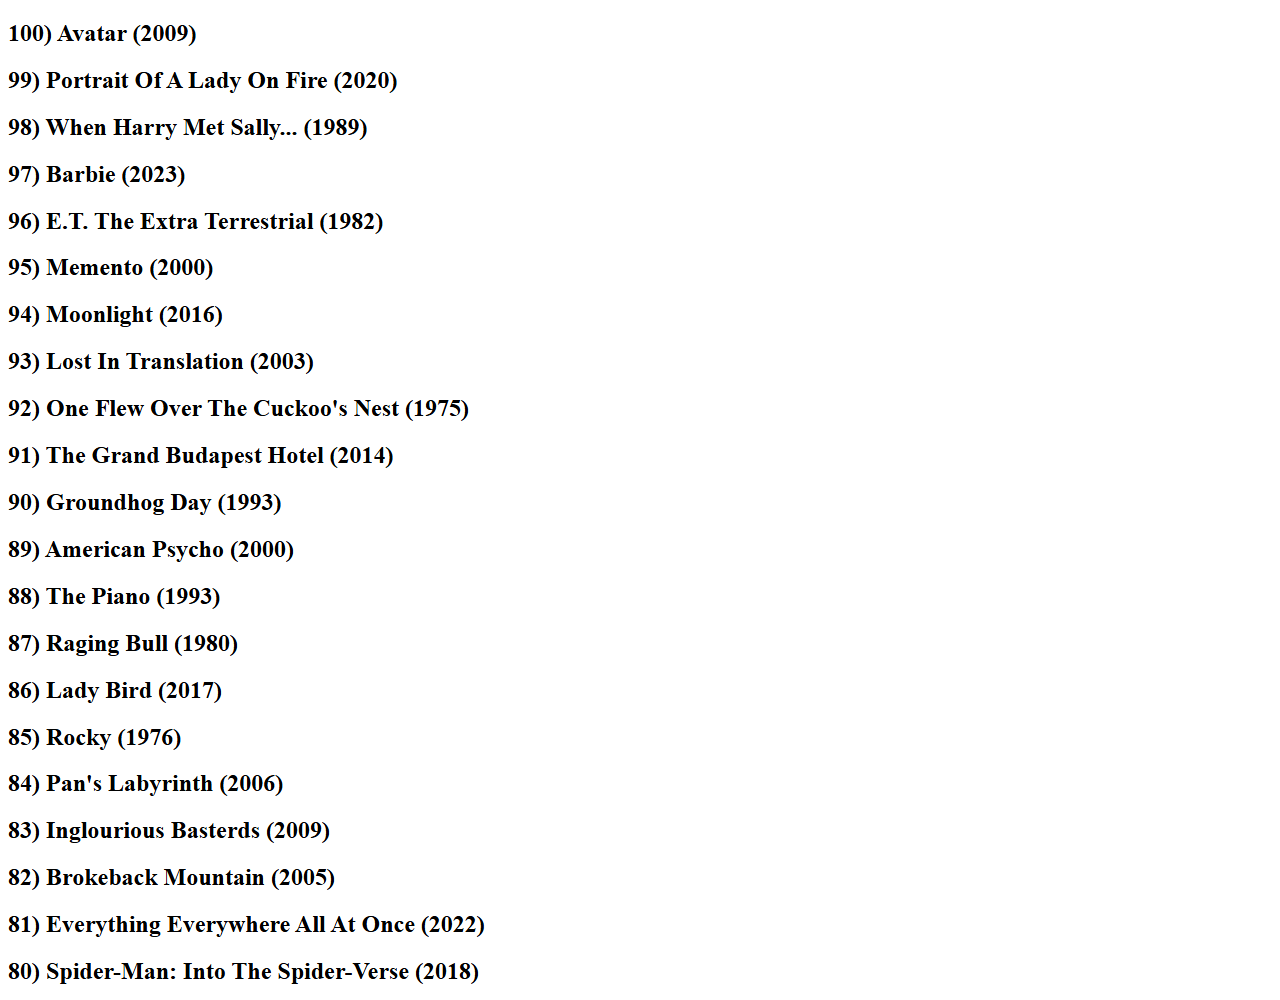
Tugasan mengunci syot kilat Internet Archive bagi senarai Empire kerana laman langsung sentiasa berubah. Tangkapan skrin menunjukkan tajuk halaman yang disimpan.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** syot kilat yang dikunci menjadikan pengikis boleh diulang.
|
||||
|
||||
## Langkah 2: periksa markup
|
||||
|
||||
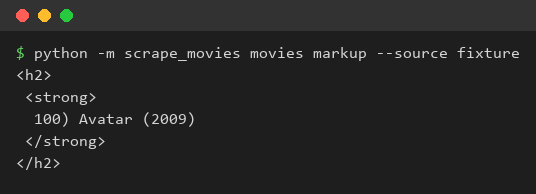
Halaman 2020 mempunyai `<h3 class="title">`; halaman semasa mempunyai tajuk `<h2><strong>` yang bermula dengan kedudukan.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** apabila laman mengubah markup, penghurai mesti berubah bersama, jadi kita menampung kedua-dua susunan.
|
||||
|
||||
## Langkah 3: tajuk mengikut susunan halaman
|
||||
|
||||
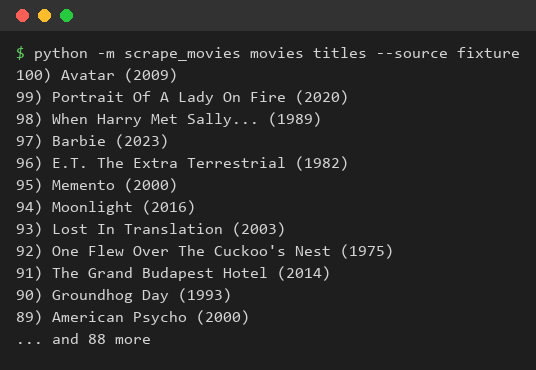
`select("h3.title")` dan list comprehension pada `get_text()`. Halaman mengira turun dari 100.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** list comprehension ialah cara ringkas mengumpul teks daripada banyak tag.
|
||||
|
||||
## Langkah 4: terbalikkan senarai
|
||||
|
||||
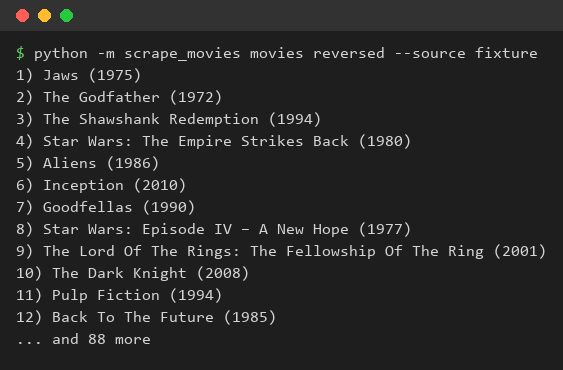
`titles[::-1]` menjadikan senarai mengira naik dari 1.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** hirisan dengan langkah negatif membalikkan senarai dalam satu ungkapan.
|
||||
|
||||
## Langkah 5: tulis movies.txt
|
||||
|
||||
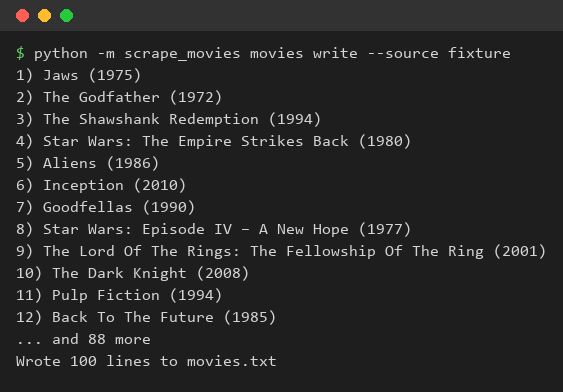
Blok `with open(...)` menulis satu tajuk setiap baris.
|
||||
|
||||
|
||||
|
||||
**Apa yang kita pelajari:** pengurus konteks menutup fail untuk kita, dan larian yang sama sentiasa menghasilkan fail yang sama.
|
||||
|
||||
## Langkah 6: hasilnya
|
||||
|
||||
|
||||
|
||||
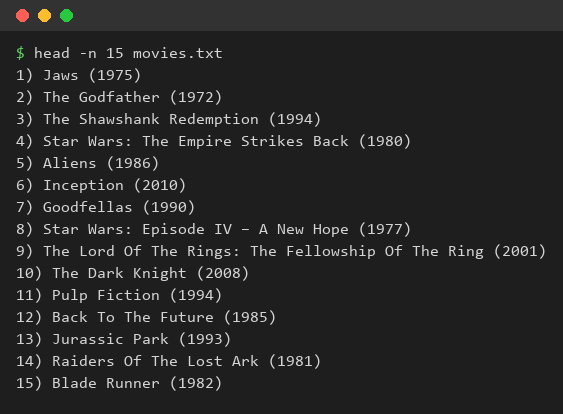
**Apa yang kita pelajari:** senarai tontonan peribadi daripada sebuah laman web, sedia untuk memilih filem secara rawak.
|
||||
|
||||
## Nota tentang data
|
||||
|
||||
`movies.txt` dihasilkan daripada senarai Empire semasa pada 2026-10-28, jadi kedudukannya berbeza daripada senarai 2020 dalam kuliah. Internet Archive menjawab `429 Too Many Requests` semasa kami membina projek ini, jadi susunan syot kilat dilindungi oleh contoh tulisan tangan dalam ujian.
|
||||
|
||||
## Apa yang kita pelajari
|
||||
|
||||
Kita boleh mengikis senarai berkedudukan, menyusunnya mengikut keperluan dan menyimpannya dalam fail.
|
||||
Reference in New Issue
Block a user